
Benchmark chỉ hữu ích khi phép đo có thể đối chiếu
Benchmark mô hình AI là phép thử dùng bộ tác vụ và tiêu chí xác định để ước lượng cách một mô hình xử lý công việc; giá trị của nó phụ thuộc vào việc các phiên bản được thử trong cùng điều kiện và có phương pháp công khai. Vì vậy, so sánh mô hình AI không nên bắt đầu và kết thúc bằng một con số trên bảng xếp hạng. Người dùng cần biết mô hình nào đã được kiểm tra, có thể truy cập hay chưa, và điểm số được tạo ra bằng quy trình nào.
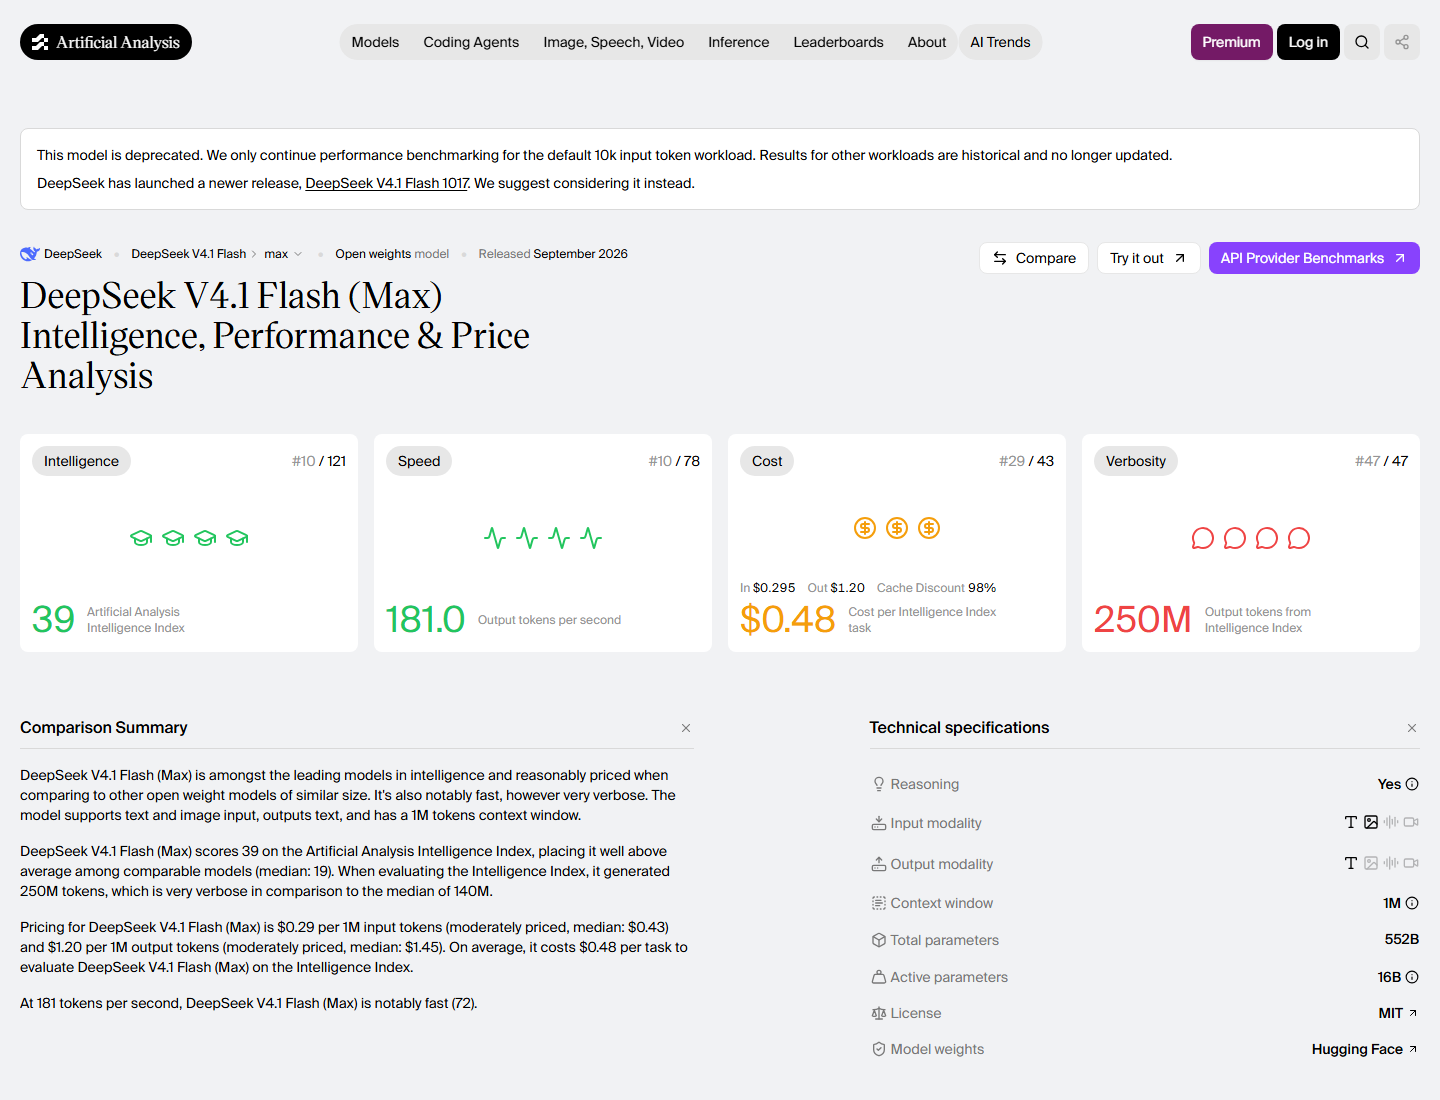
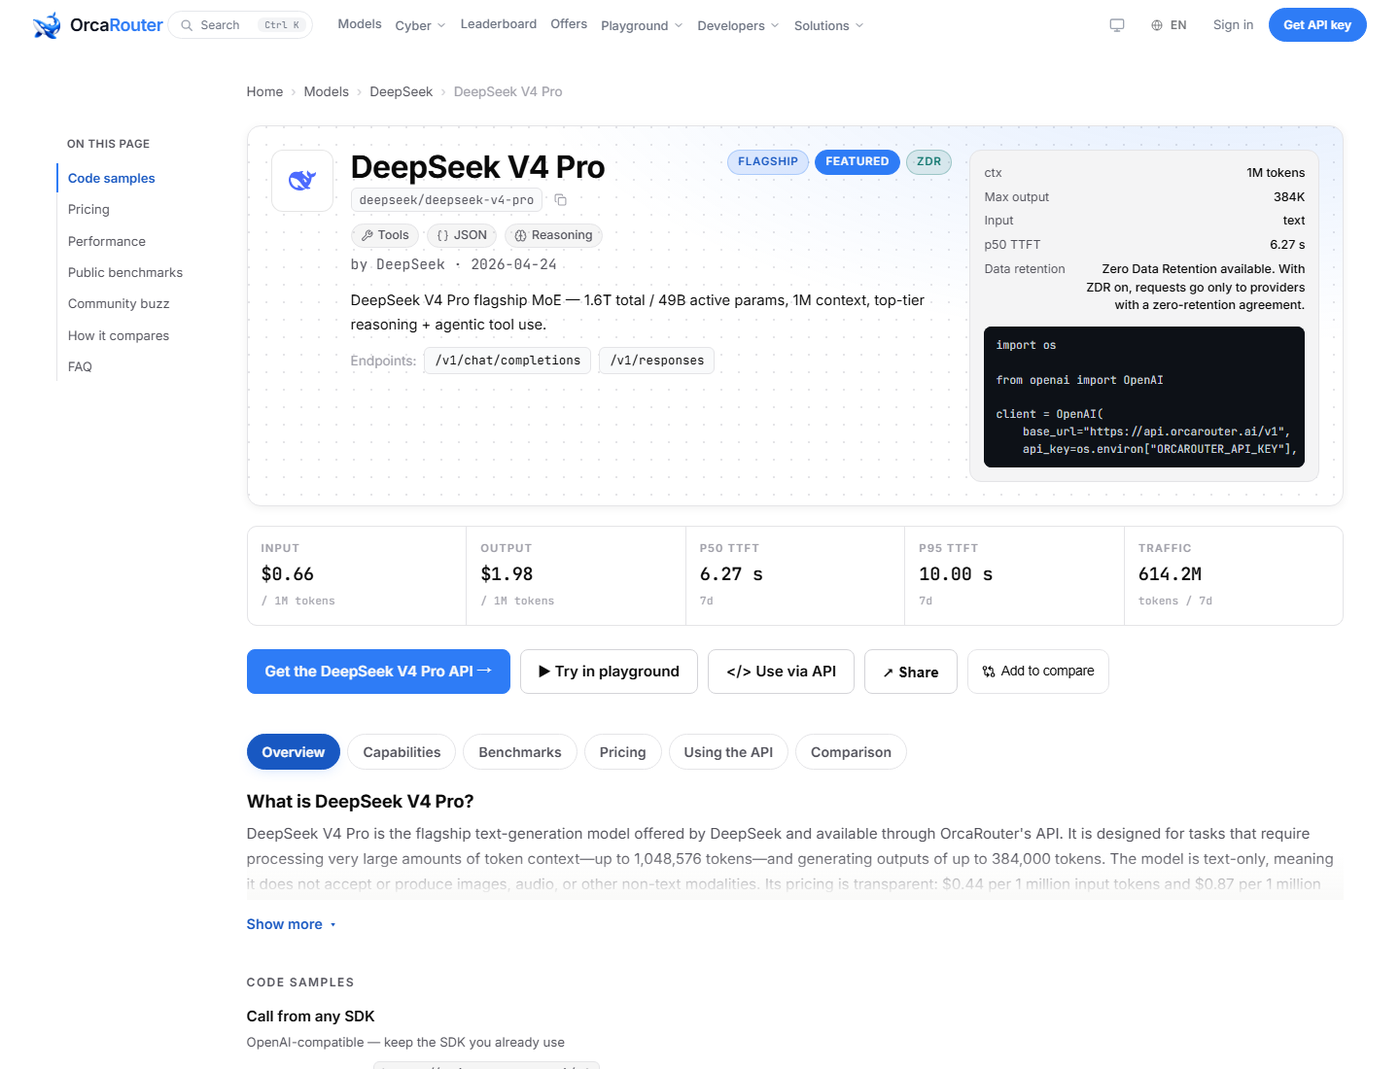
V4.1 Flash cho thấy vì sao điểm mạnh vận hành dễ nhìn hơn chất lượng câu trả lời: mô hình này được công bố có giá thấp hơn V4 Pro, thời gian trả token đầu tiên ngắn hơn, năng lực xử lý đồng thời cao hơn và hỗ trợ hình ảnh trong khi Pro không có. Các số liệu được nêu lần lượt là 0,15 so với 0,66 cho mỗi triệu token đầu vào, 1,49 so với 6,22 giây, và 2.500 so với 500 yêu cầu đồng thời. Đây là chênh lệch đáng kể với người dùng, nhưng chưa chứng minh Flash chính xác hơn.
Điểm mấu chốt là độ chính xác của V4 Pro chưa được công bố trong một phép so sánh cùng bộ tác vụ với Flash. Người mua vẫn có thể chọn Pro vì tin rằng mô hình lớn hơn trả lời tốt hơn, nhưng niềm tin đó không thay thế được dữ liệu đối chứng. Độ trễ mô hình AI và năng lực phục vụ quyết định trải nghiệm, còn đánh giá AI về chất lượng cần phép thử được công bố. Với tác vụ sản xuất, có thể chuyển một phần nhỏ lưu lượng sang Flash trong khi giữ hệ thống chính trên Pro, rồi theo dõi số lần thử lại, token đầu ra mỗi tác vụ hoàn tất và độ trễ p95.
Một mô hình có thật, một cái tên chưa thể gọi
Trường hợp Ripple 65B Preview và DeepSeek V4.1 Pro nhắc rằng trước khi so điểm, phải xác nhận cả hai đối tượng có tồn tại và có thể truy cập hay không. Ripple 65B Preview được công bố phát hành ngày 4 tháng 11 năm 2026, với giấy phép Apache 2.0 và 65 tỷ tham số. Trái lại, V4.1 Pro không có thẻ mô hình, mã định danh API, bảng giá hay kết quả benchmark được nêu; yêu cầu gọi tên mô hình này qua cổng trung gian cũng trả về lỗi không tìm thấy. So hai bên như thể đều là sản phẩm sẵn sàng sử dụng sẽ biến phân tích thành so sánh mô hình với tin đồn.
Tín hiệu kiểm chứng nên là thông tin truy cập cụ thể, không phải tên gọi hợp lý hay lời hứa trong ghi chú phát hành. DeepSeek từng nhắc V4.1 Pro như một phiên bản sẽ ra mắt, nhưng danh sách mô hình đang hoạt động chỉ cho thấy Flash và Pro với các phiên bản cụ thể khác. Ripple, ngược lại, có bản phát hành và thông tin giấy phép để người dùng xác minh. Một benchmark của Ripple được nêu ở mức 80,52 trên Terminal-Bench 2.1, nhưng con số ấy chỉ có ý nghĩa khi đặt cạnh kết quả trên cùng phiên bản và phương pháp.
Nếu cần một mô hình 65B mở trọng số để tự chạy, Ripple là lựa chọn có thật theo thông tin hiện có; số liệu ra mắt được mô tả là gần V4 Flash trên Terminal-Bench nhưng yếu hơn trên DeepSWE. Đó vẫn chưa phải lý do để coi mọi tuyên bố hiệu năng là kết luận độc lập. Hãy chờ model ID hoạt động, tài liệu truy cập và phương pháp thử nghiệm trước khi thêm một phiên bản chưa phát hành vào bảng so sánh. Việc kiểm tra này không cầu kỳ, nhưng ngăn đội ngũ chọn công nghệ dựa trên một sản phẩm chưa thể gọi.

Điểm số gần nhau không có nghĩa cùng một bài thi
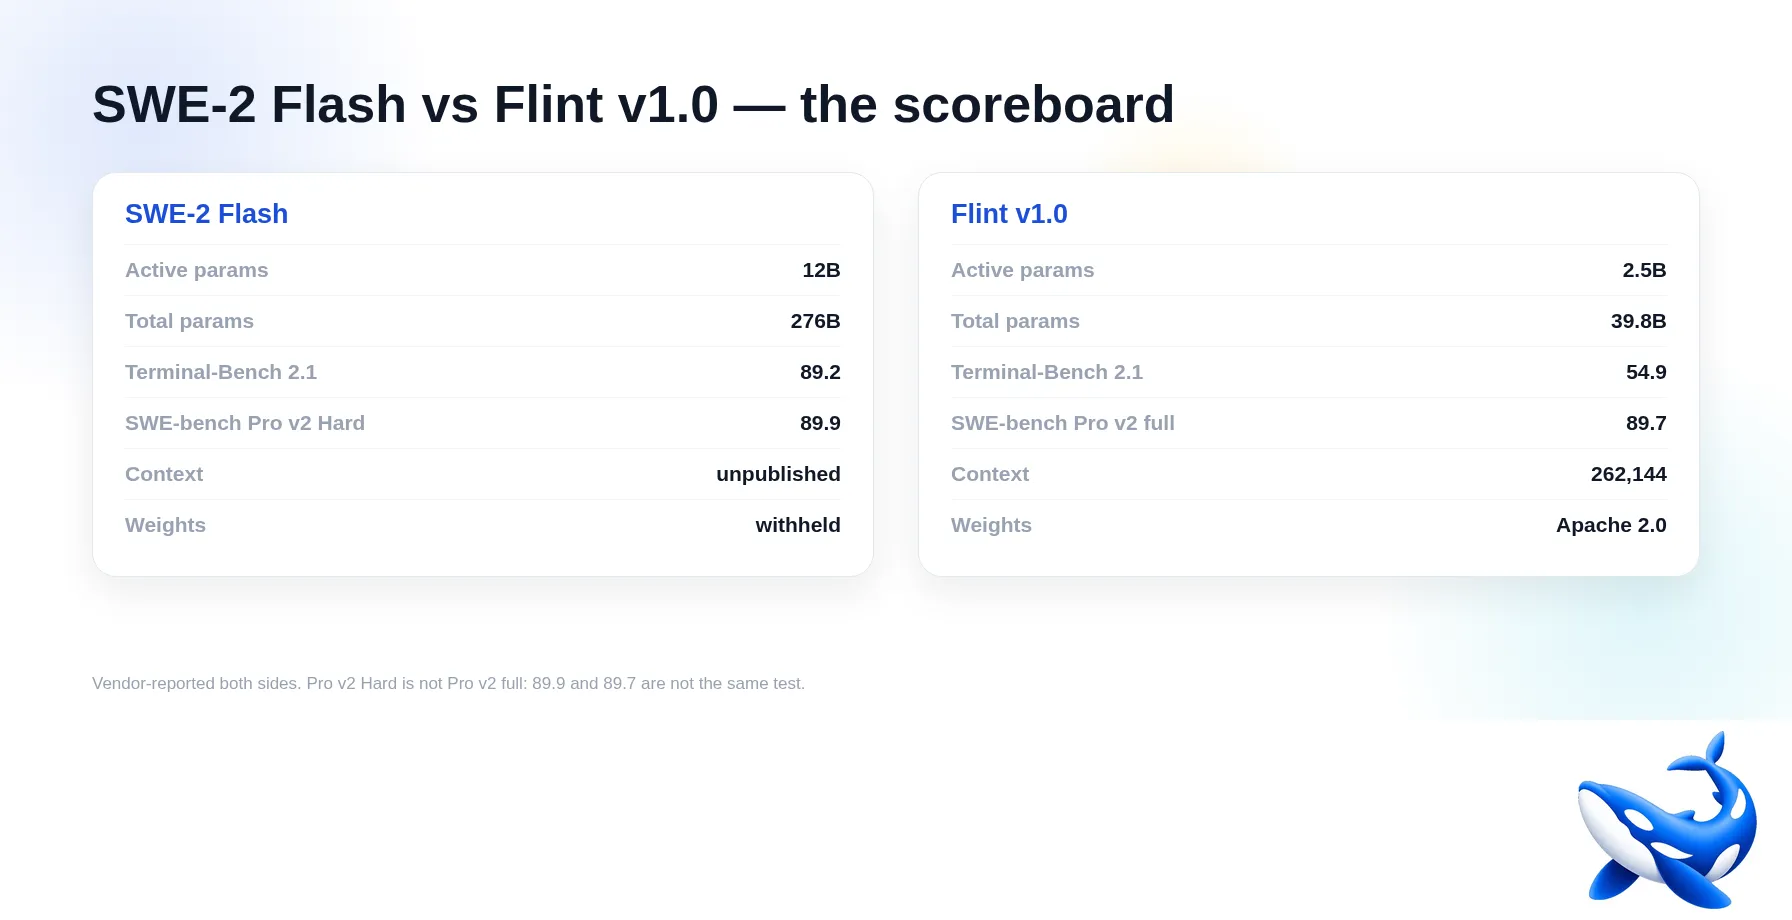
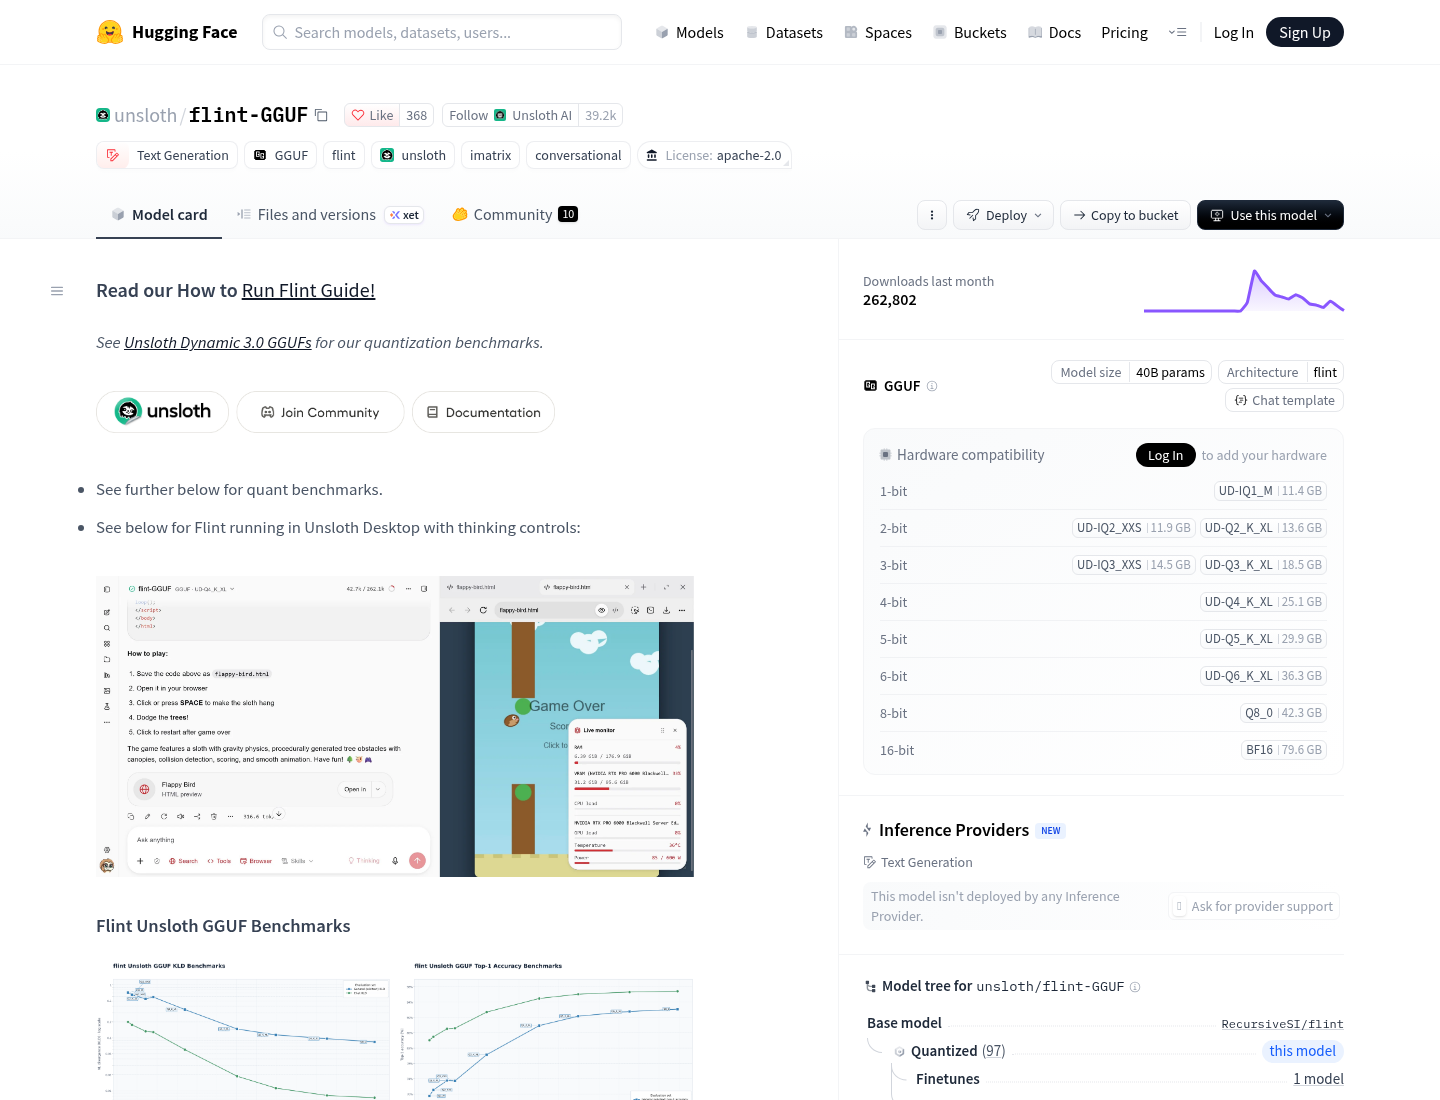
SWE-2 Flash và Flint v1.0 cho thấy rủi ro tinh vi hơn: hai điểm số gần nhau có thể bị đặt cạnh nhau dù đo các tập tác vụ khác nhau. Flint được báo cáo đạt 89,7 trên SWE-bench Pro v2, còn SWE-2 Flash đạt 89,9 trên SWE-Bench Pro v2 Hard. Chênh lệch chỉ 0,2 điểm trông như một cuộc so kè sát nút, nhưng “Hard” là tập con đã lọc, không phải toàn bộ bộ tác vụ. Vì thế, hai con số không phải cùng một phép đo và không thể dùng trực tiếp để tuyên bố mô hình nào thắng.
Ngay cả dòng Terminal-Bench 2.1, nơi cả hai có số liệu trên cùng phiên bản, cũng cần đọc kèm điều kiện. SWE-2 Flash đạt 89,2; Flint v1.0 đạt 54,9. Đây là khoảng cách lớn trên một bộ nhiệm vụ chung, nhưng cách tạo điểm không minh bạch ngang nhau: Flint công bố dùng Terminus 2 và lấy trung bình pass@1 qua ít nhất năm lần thử, còn Cognition không nêu tên harness hay mức nỗ lực thử nghiệm. Kết quả đáng chú ý, nhưng thiếu khả năng kiểm chứng độc lập thì chưa đủ làm phán quyết cuối cùng.
Lựa chọn còn phụ thuộc vào quyền kiểm soát và cách triển khai. Flint có trọng số Apache 2.0 để chạy trên phần cứng riêng, phù hợp với yêu cầu lưu trú dữ liệu, vận hành ngoại tuyến hoặc tinh chỉnh. SWE-2 Flash hiện gắn với Devin Desktop và Devin CLI, miễn phí đến hết ngày 30 tháng 11 năm 2026; giá theo token sau đó chưa được công bố. Nếu cần trọng số và quyền tự vận hành, khoảng cách điểm benchmark có thể là đánh đổi chấp nhận được. Đừng chọn một trong hai chỉ vì các số SWE-bench trông gần nhau.
Quy trình chọn mô hình đáng tin hơn bảng xếp hạng
Một đánh giá AI hữu ích phải đặt hiệu năng cạnh khả năng sử dụng: chi phí theo cách tính được công bố, độ trễ, năng lực đồng thời, quyền truy cập, giấy phép và mức độ phù hợp với dữ liệu của tổ chức. Nhưng mọi con số đều cần được gắn với phiên bản chính xác. Terminal-Bench 2.1 và 4.0 là các bộ tác vụ khác nhau; thay đổi phiên bản có thể làm điểm số dịch chuyển mạnh, nên không thể xem tên benchmark gần giống nhau như bảo đảm rằng phép đo tương đương.
- Xác minh model ID, phiên bản, tài liệu truy cập và tình trạng phát hành.
- Đọc bộ tác vụ, harness, mức nỗ lực, số lần chạy và cách tính điểm.
- Đối chiếu nguồn công bố, ưu tiên kết quả có phương pháp đủ chi tiết và kiểm chứng độc lập.
- Thử trên tác vụ thực tế của mình; theo dõi chất lượng hoàn thành, số lần thử lại và độ trễ p95.
Kết luận cần giữ tỉnh táo: benchmark không vô dụng, nhưng điểm số không tự nói lên toàn bộ câu chuyện. V4.1 Flash có lợi thế vận hành được nêu rõ mà chưa có đối chứng công khai về độ chính xác; V4.1 Pro chưa đủ thông tin để đem ra so; còn cặp SWE-2 Flash–Flint cho thấy một phép đo chung vẫn cần phương pháp minh bạch. Hãy chọn mô hình dựa trên phiên bản đã xác minh, bài thử có thể đối chiếu và kết quả trong môi trường của chính bạn—not một con số đẹp đứng riêng lẻ.