
Giá thấp hơn là điểm đáng chú ý nhất
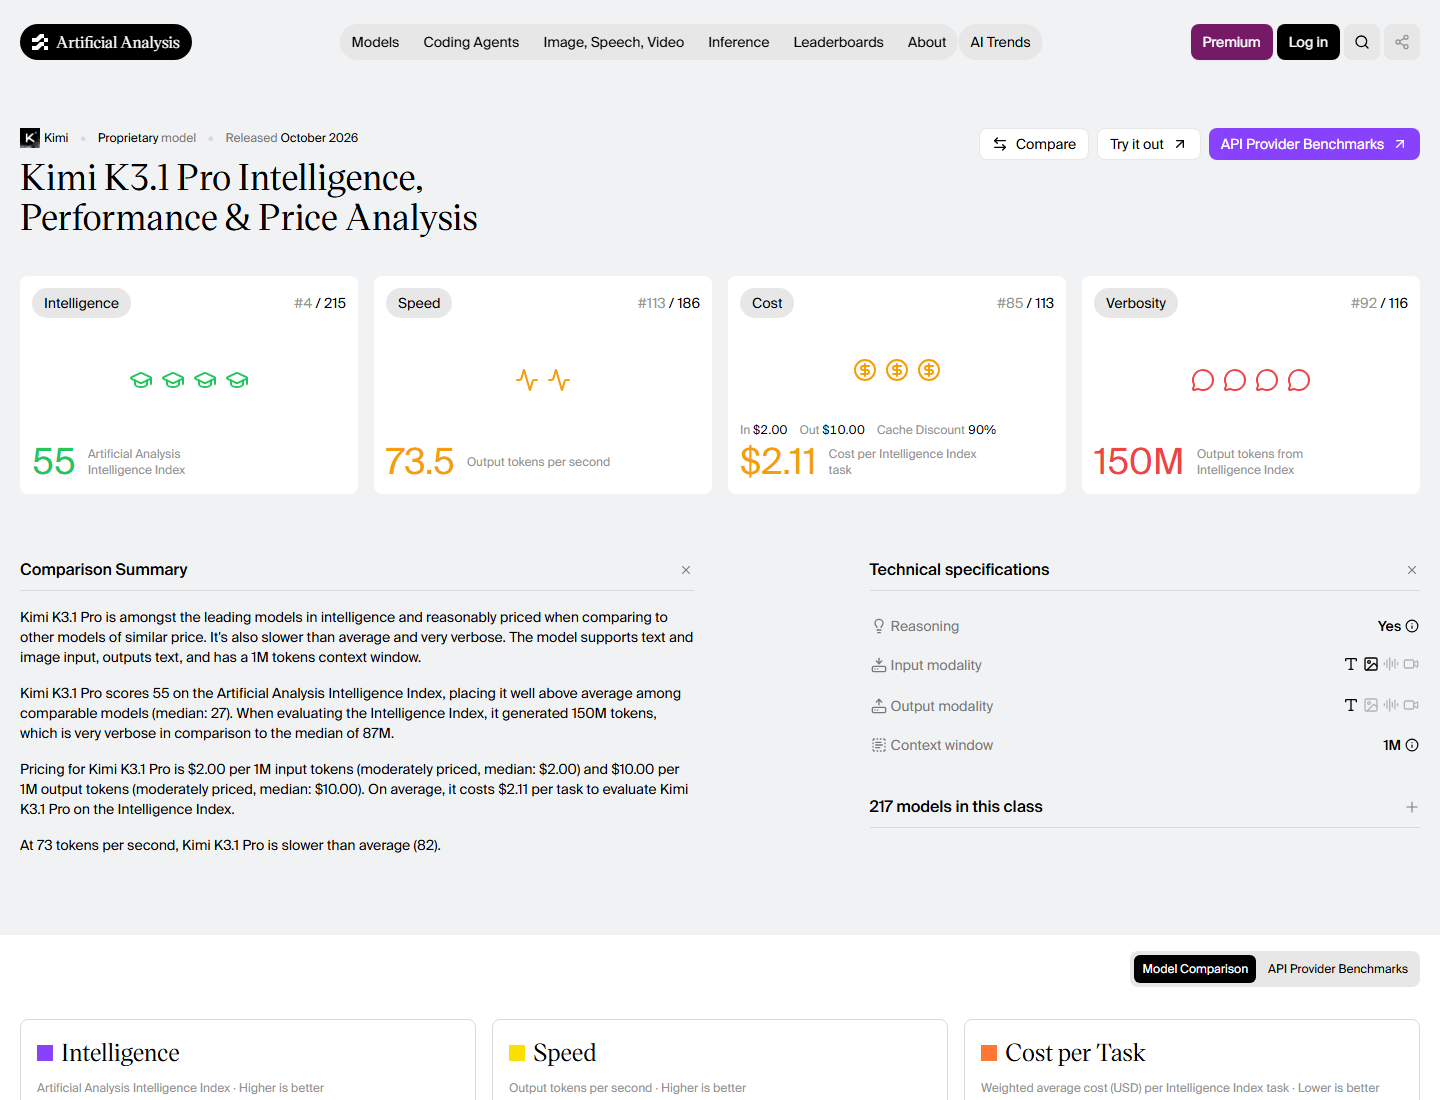
Kimi K3.1 Pro là phiên bản hậu huấn luyện của mô hình Kimi K3 do Moonshot AI phát hành ngày 24 tháng 10 năm 2026, hướng đến cải thiện hành vi mà không thay kiến trúc nền. Điểm đáng chú ý nhất với người dùng không phải lời hứa về năng lực mới, mà là mức giá token thấp hơn trong khi nhiều chỉ số benchmark vẫn cần được đọc thận trọng.
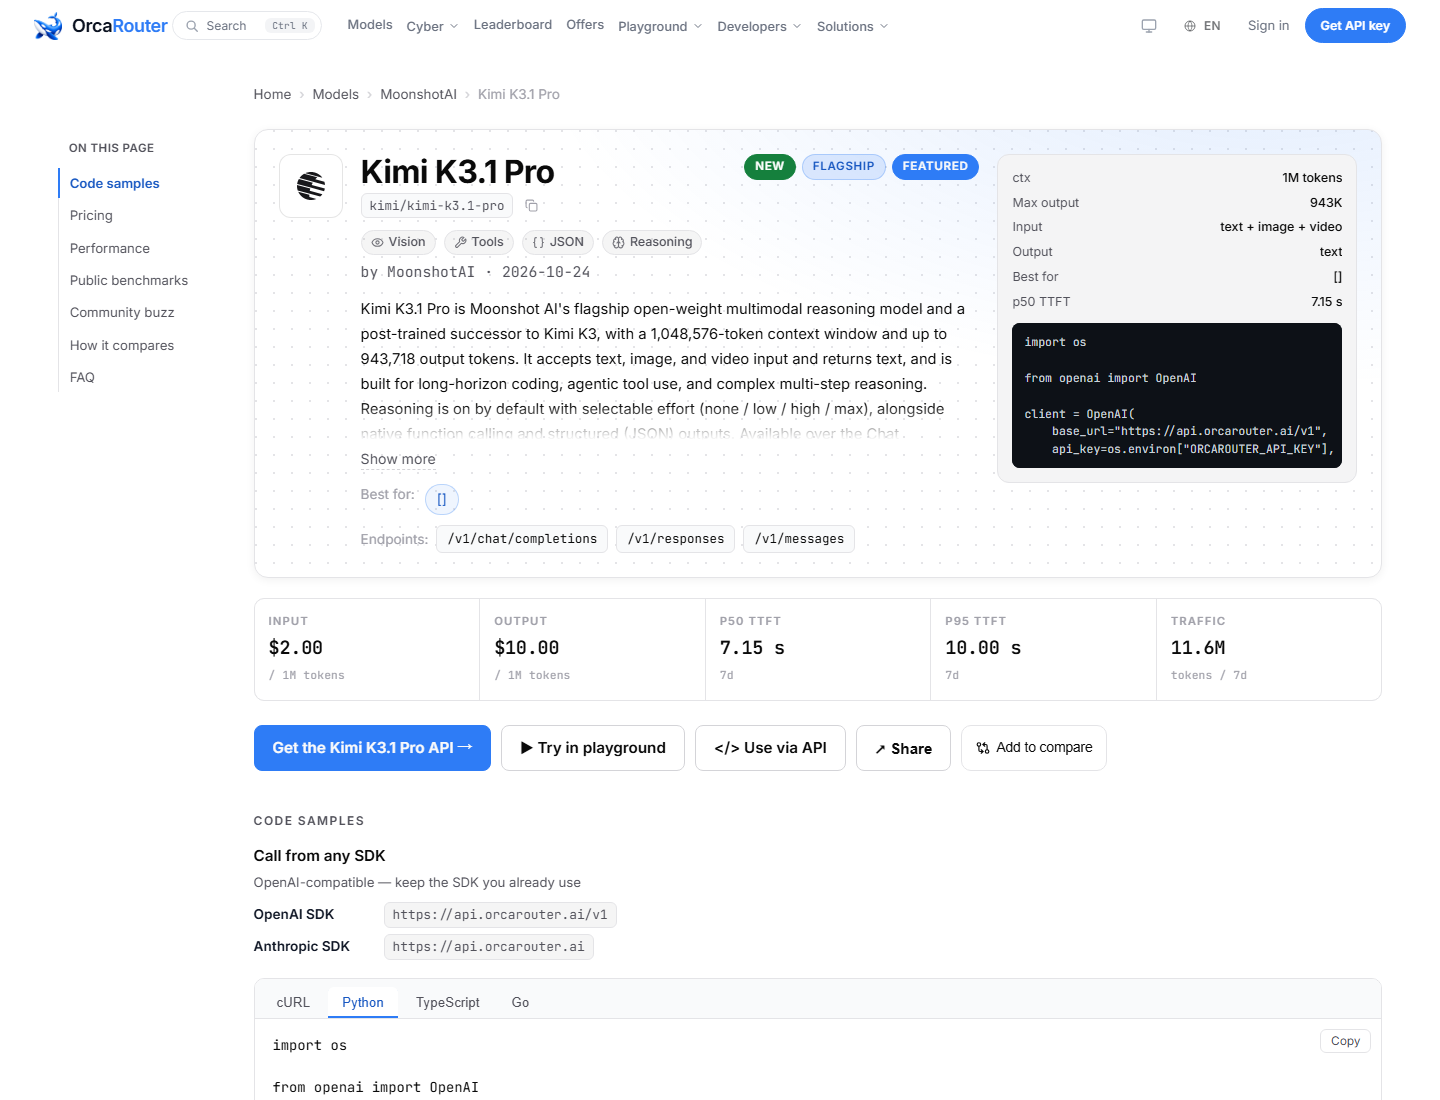
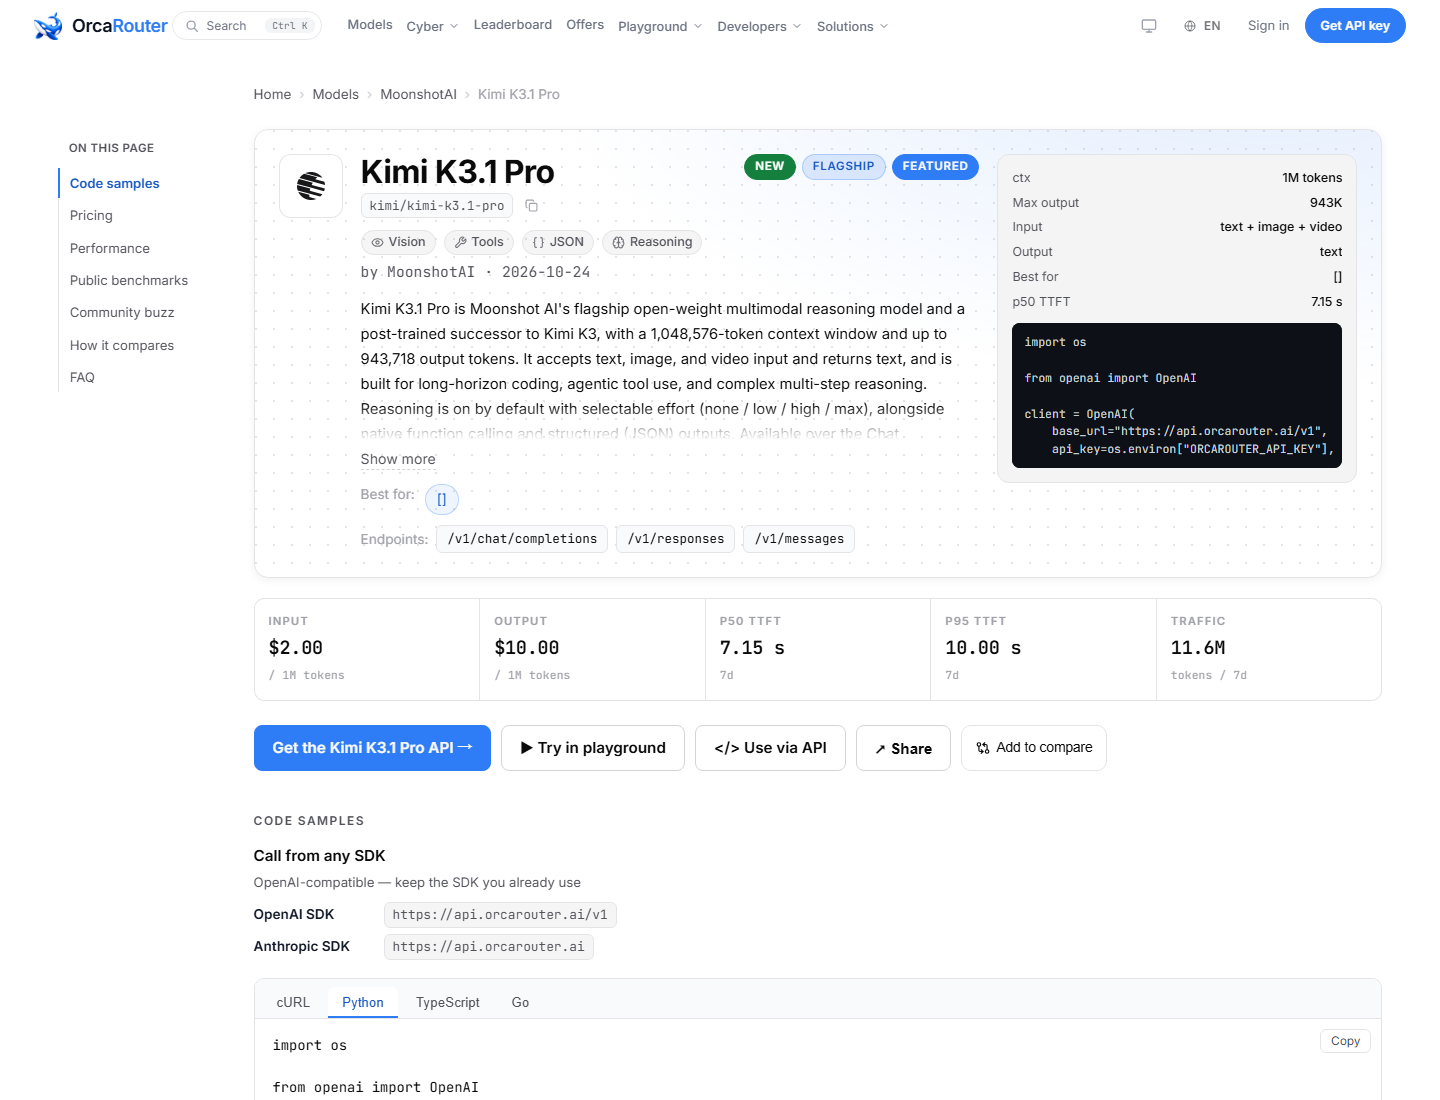
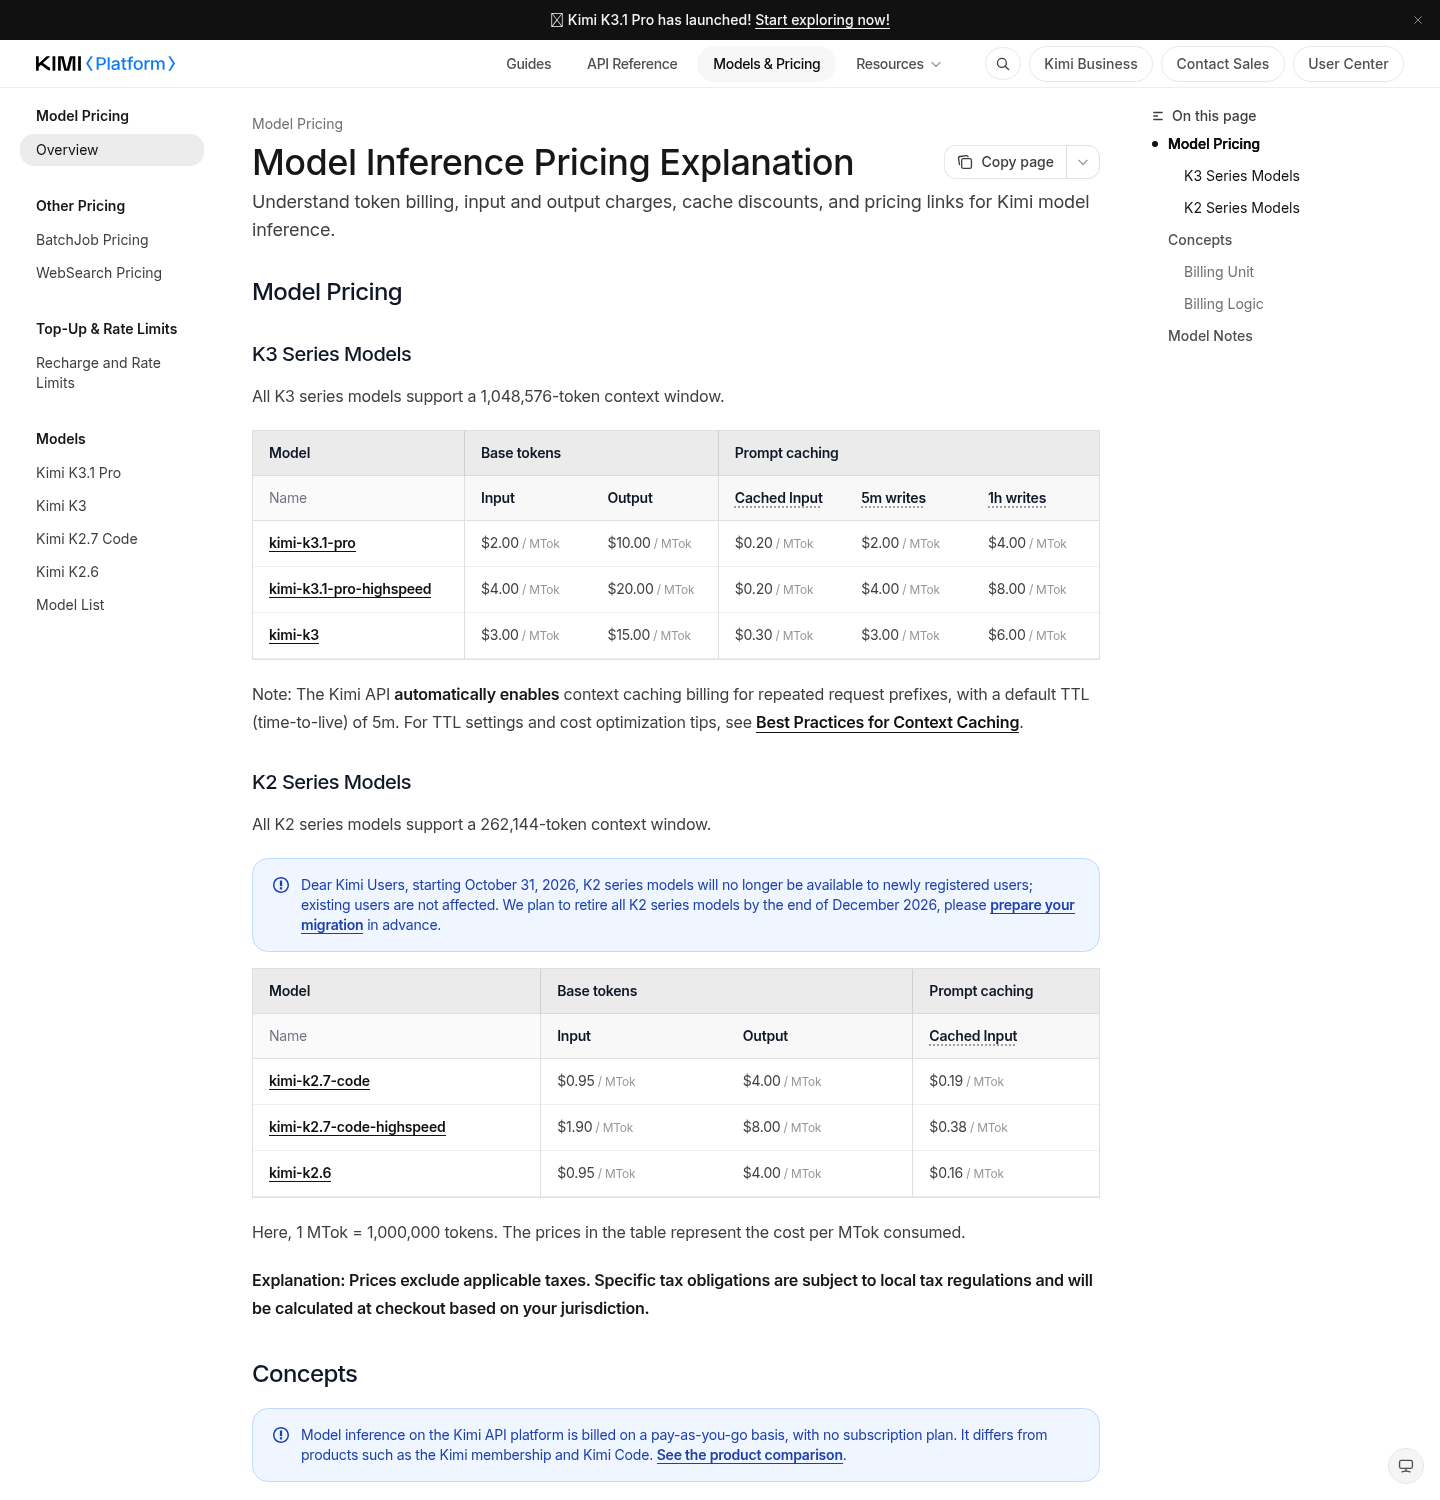
Mức giá đầu vào và đầu ra của Kimi K3.1 Pro thấp hơn một phần ba so với Kimi K3, một thay đổi có ý nghĩa trực tiếp với nhóm thường xử lý kho mã lớn hoặc tài liệu dài. Tuy nhiên, giá token Kimi không tự động cho biết tổng chi phí của một tác vụ: mô hình được ghi nhận là tạo nhiều token đầu ra, vốn là phần tính phí đắt hơn. Vì thế, hóa đơn giảm theo đơn giá chưa chắc đồng nghĩa mọi quy trình đều rẻ hơn tương ứng.
Moonshot nói đây là đợt hậu huấn luyện với lượng tính toán lớn hơn, gồm học tăng cường trên nhiều lĩnh vực, chứ không phải kiến trúc mới. Cửa sổ ngữ cảnh vẫn ở mức một triệu token. Với người dùng phổ thông, mức giá thấp hơn là lợi ích dễ kiểm chứng; còn lời hứa về năng lực chỉ đáng tin sau khi thử trên tác vụ thật.
Hai điểm benchmark không đo cùng một thứ
Sự vênh giữa các con số không nên được diễn giải như một bên đúng, bên kia sai. Artificial Analysis chấm Kimi K3.1 Pro 55 điểm trên Intelligence Index và xếp thứ tư trong nhóm gồm 215 mô hình. Đây là chỉ số tổng hợp từ nhiều bài đánh giá, không phải điểm của riêng một bài kiểm tra lập trình.
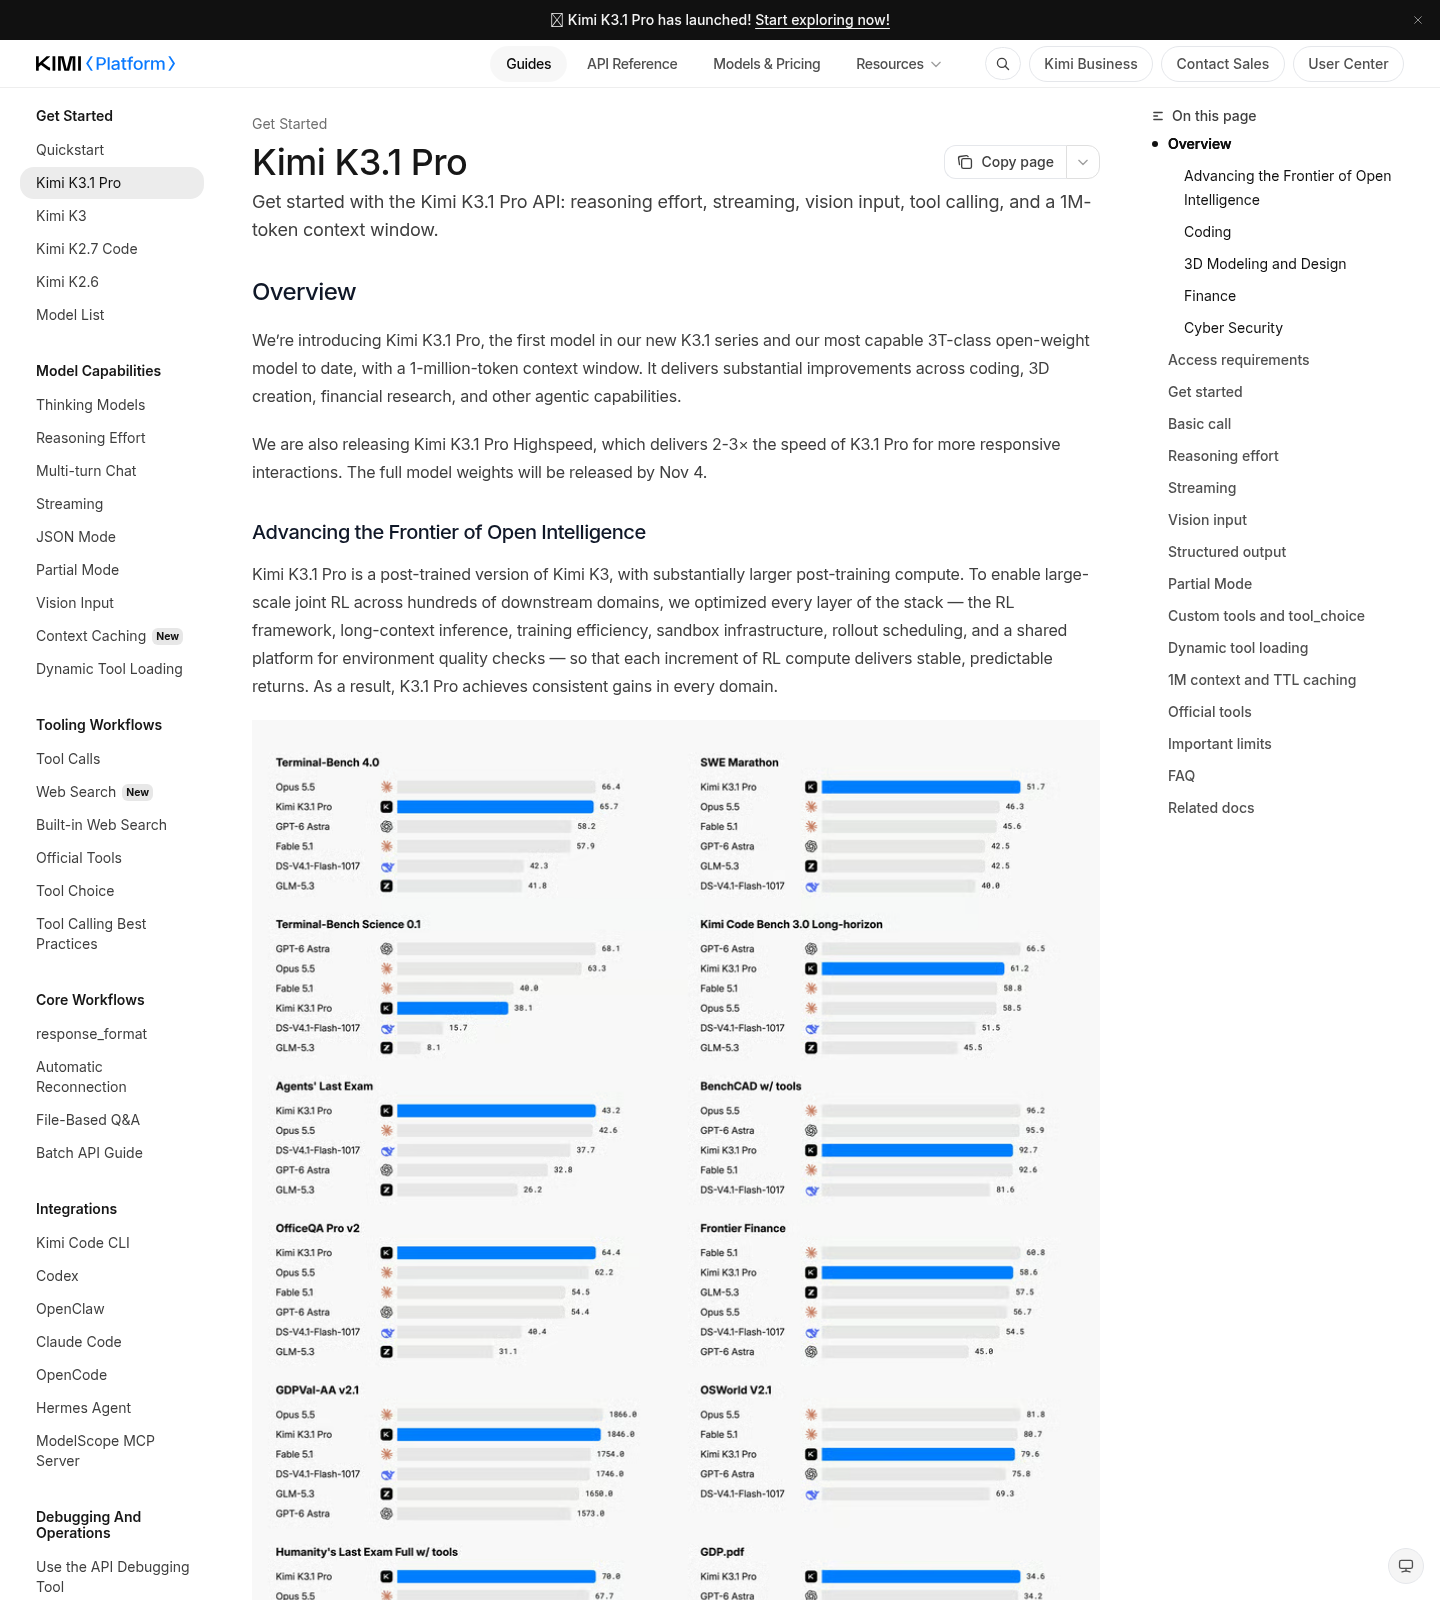
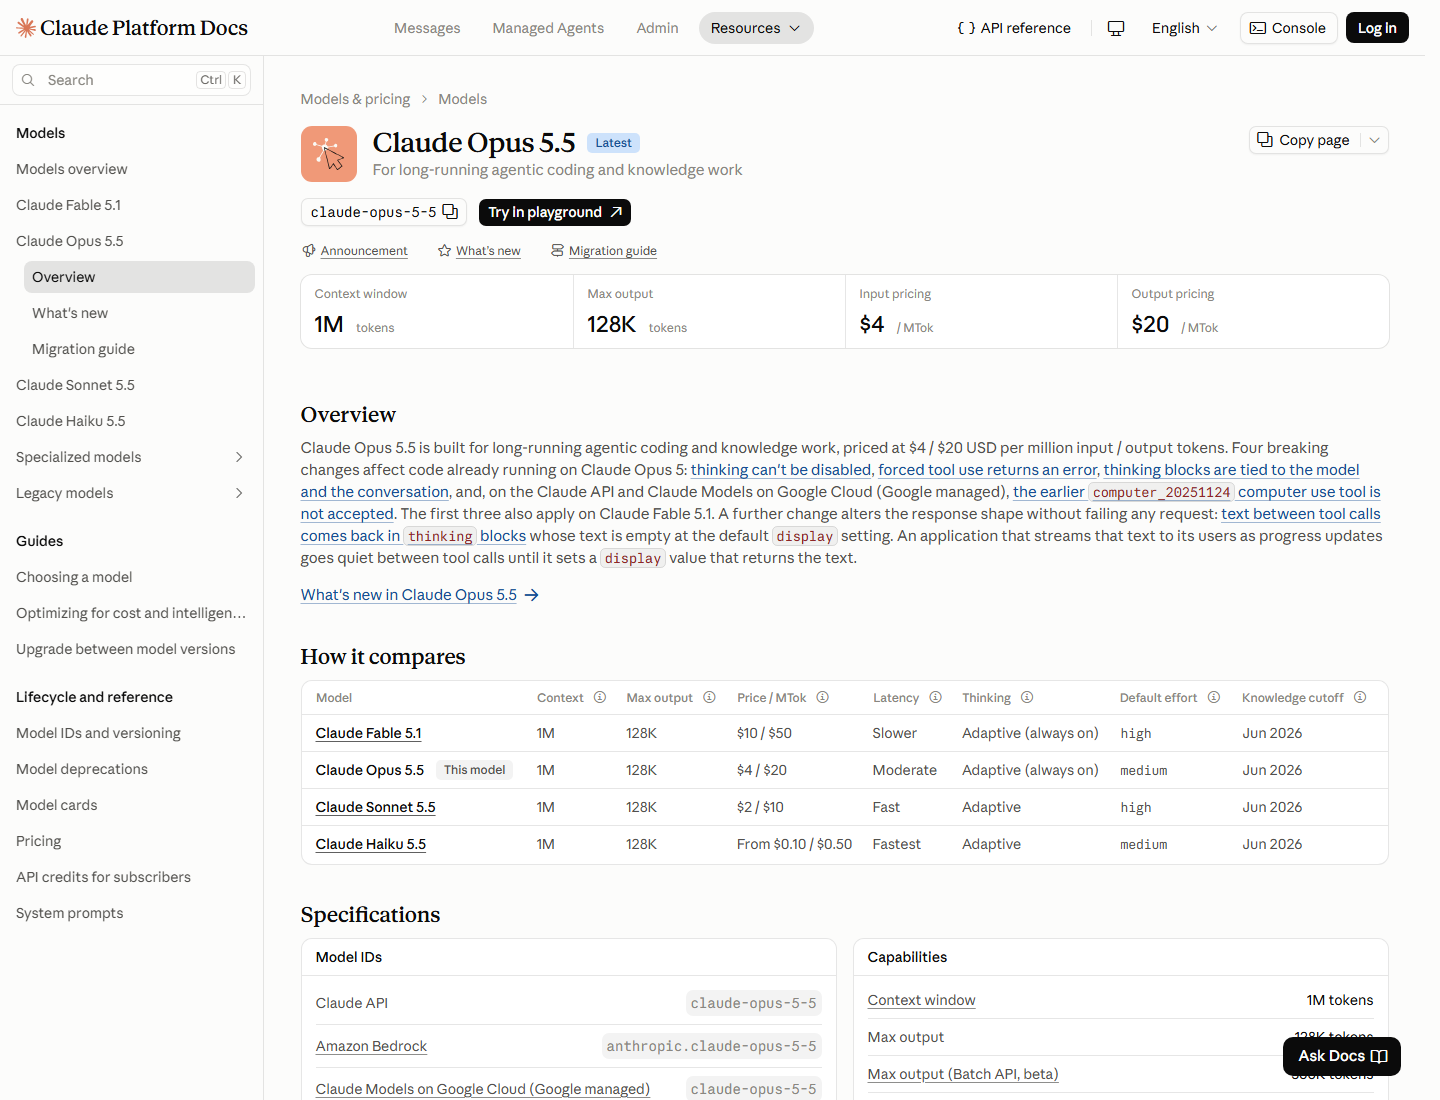
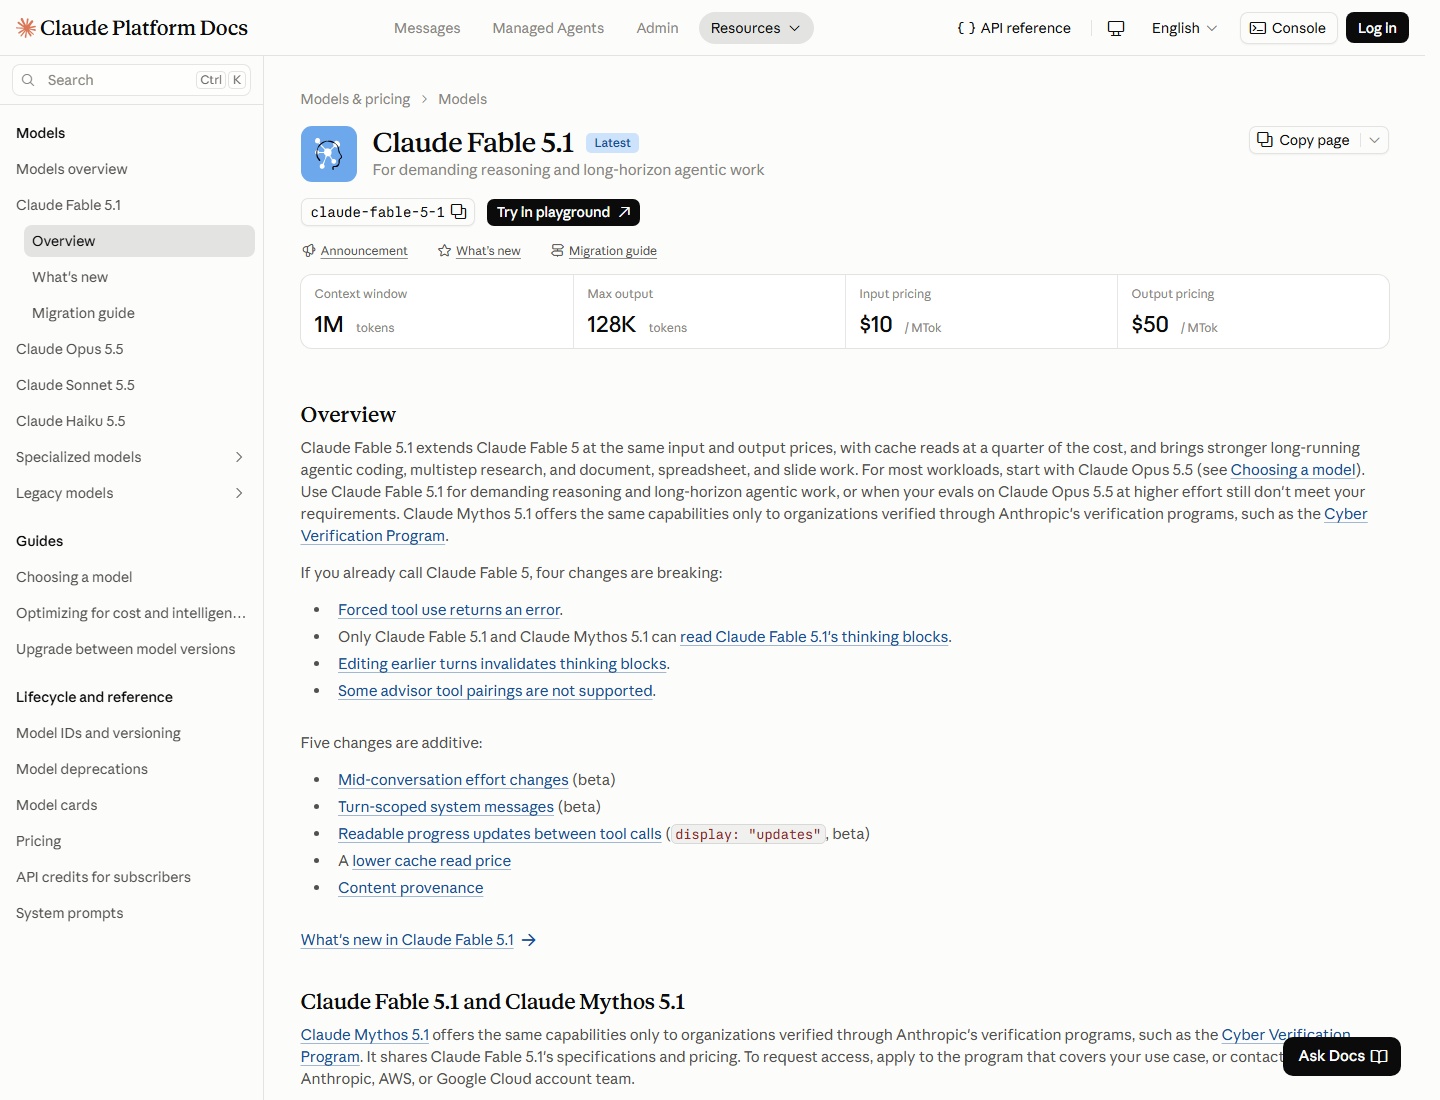
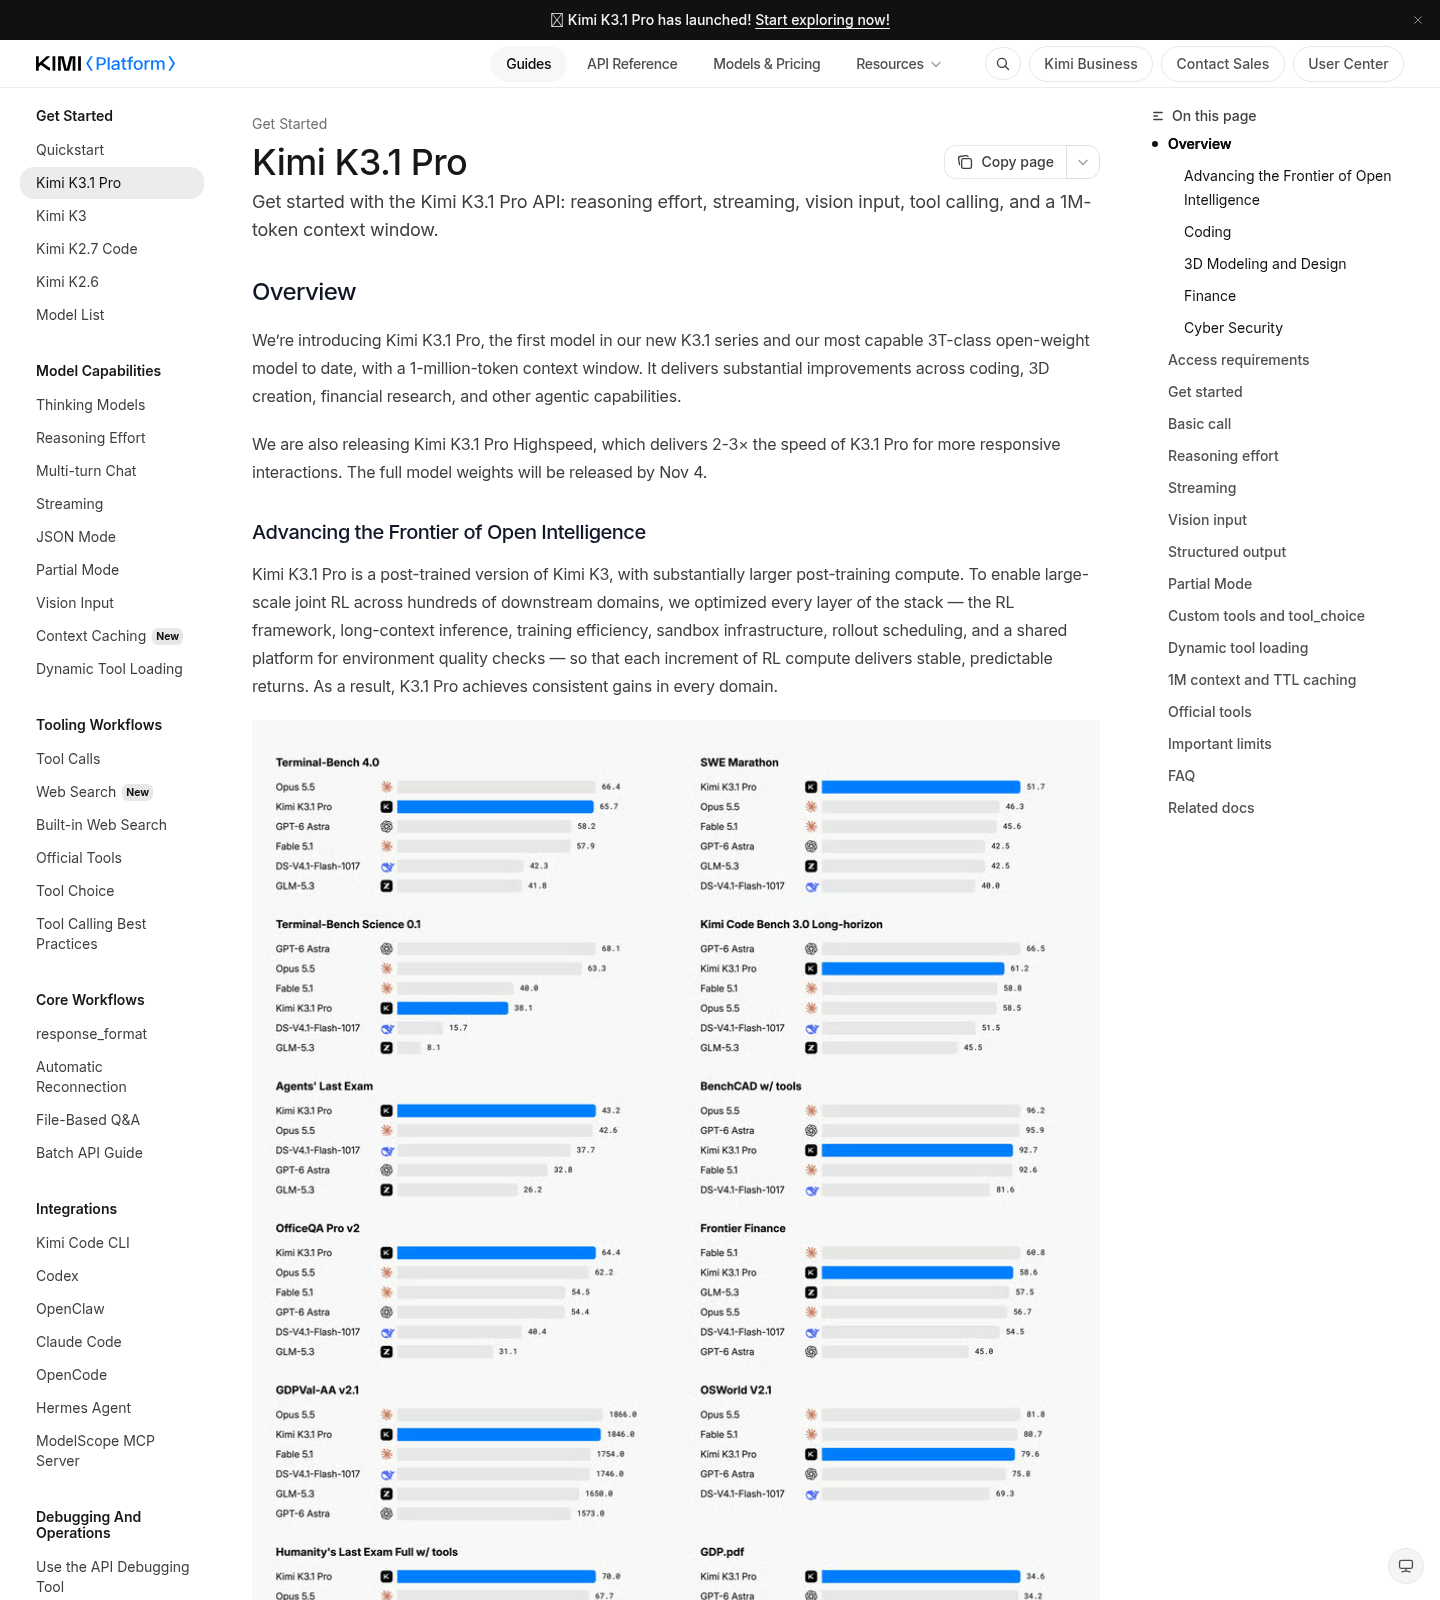
Trong khi đó, bảng của Moonshot ghi Terminal-Bench 4.0 đạt 65,7%, cao hơn mức 58,2% được ghi cho GPT-6 Astra nhưng thấp hơn 66,4% của Claude Opus 5.5. Vì vậy, cụm từ khóa Terminal-Bench 65.7 nói về một phép thử cụ thể do nhà phát triển công bố, không thể đặt cạnh điểm 55 như hai kết quả cùng thang đo. Các con số cùng có giá trị tham khảo, nhưng trả lời những câu hỏi khác nhau.
So sánh còn bị ảnh hưởng bởi cách chạy bài: thiết lập nỗ lực suy luận và bộ công cụ hỗ trợ có thể làm thay đổi kết quả. Ở Terminal-Bench, mức nỗ lực của Claude được ghi nhận cao hơn mặc định, còn hai bên dùng bộ khung đánh giá khác nhau. Do đó, bảng điểm là một phần của bằng chứng, không phải bảng xếp hạng tuyệt đối.
Bảng điểm còn khoảng trống, nên đọc có chọn lọc
Một bảng benchmark Kimi có nhiều hạng mục do chính Moonshot chọn và đánh giá, nên các kết quả nội bộ hữu ích nhất để theo dõi tiến bộ của hãng qua từng phiên bản. Chẳng hạn, Kimi K3.1 Pro đạt 61,2% trong bài kiểm tra lập trình dài hạn của Moonshot, so với 55,95% của Kimi K3. Đây là so sánh trực tiếp, nhưng bài kiểm tra và bộ khung đều do cùng một công ty xây dựng.
Những ô trống cũng quan trọng như điểm đã công bố. Ở Terminal-Bench-Science 0.1, Moonshot chỉ nói mô hình vượt K3, nhưng không nêu con số; trong khi điểm của Claude Opus 5.5 được công bố là 58,7%. Ở một số dòng khác, đối thủ không có kết quả tương ứng. Không nên xem dữ liệu thiếu là bằng chứng mô hình yếu, nhưng cũng không thể dùng chúng để tuyên bố mô hình dẫn đầu.
Cách đánh giá hợp lý là phân biệt kết quả độc lập, bài kiểm tra của nhà cung cấp và tác vụ nội bộ, đồng thời xem xét thiết lập chạy. Nhóm kỹ thuật nên thử một mẫu lưu lượng thật ở các mức nỗ lực thấp, cao và tối đa trước khi chọn cấu hình mặc định: thiết lập có thể làm chi phí thay đổi đáng kể.
Ngày mở trọng số sẽ là phép thử tiếp theo
Moonshot dự kiến phát hành đầy đủ trọng số mô hình vào ngày 4 tháng 11 năm 2026. Nếu đúng lịch, các nhóm nghiên cứu và nhà phát triển sẽ có thêm cơ hội kiểm tra mô hình ngoài môi trường do nhà cung cấp kiểm soát. Đây là bước có thể giúp làm rõ năng lực và độ hữu dụng của Kimi K3.1 Pro hơn những tuyên bố trên bảng điểm.
Với người dùng hiện tại, lựa chọn nâng cấp nên dựa trên tác vụ và tổng chi phí vận hành, không chỉ đơn giá hay một con số benchmark nổi bật. Giá thấp hơn tạo lý do thực tế để thử, nhưng mức độ phù hợp vẫn cần được đo bằng quy trình của chính mỗi nhóm. Kết luận lúc này: Kimi K3.1 Pro đáng quan tâm vì kinh tế sử dụng, còn vị trí của nó trong nhóm mô hình hàng đầu vẫn chưa thể chốt khi các phép đo và thiết lập còn khác nhau.