
Bức tranh tổng quan: nén mô hình AI đối đầu đa phương thức
Nén mô hình AI trong bối cảnh lượng tử hóa LLM là kỹ thuật giảm kích thước trọng số và chi phí suy luận bằng cách dùng ít bit hơn cho mỗi tham số, chấp nhận đánh đổi một phần độ chính xác để mô hình có thể chạy trên thiết bị biên, di động hoặc hạ tầng tính toán hạn chế mà vẫn giữ được hành vi tổng thể hữu ích. Trong cuộc so sánh Bonsai 27B vs Qwen 3.8 27B, câu hỏi không phải “mô hình nào mạnh hơn”, mà là “công việc của bạn chạy ở đâu và bạn chấp nhận hy sinh điều gì”. Bonsai 27B 1-bit là một mô hình nhẹ 27B được nén cực mạnh để ưu tiên hiệu suất thiết bị biên, trong khi Qwen 3.8 27B là một mô hình dense đa phương thức hướng tới máy chủ với chất lượng và linh hoạt là trọng tâm. Nếu bạn cần chạy tại chỗ trên phần cứng nhỏ, Bonsai nổi bật; nếu bạn cần hiểu hình ảnh, video và ngữ cảnh dài với độ tin cậy cao, Qwen 3.8 là lựa chọn tự nhiên hơn.
| Spec | Bonsai 27B 1-bit | Qwen 3.8 27B (BF16) |
|---|---|---|
| Mô hình nền tảng | Qwen3.6-27B tái xây dựng | Qwen3.8-27B gốc Alibaba |
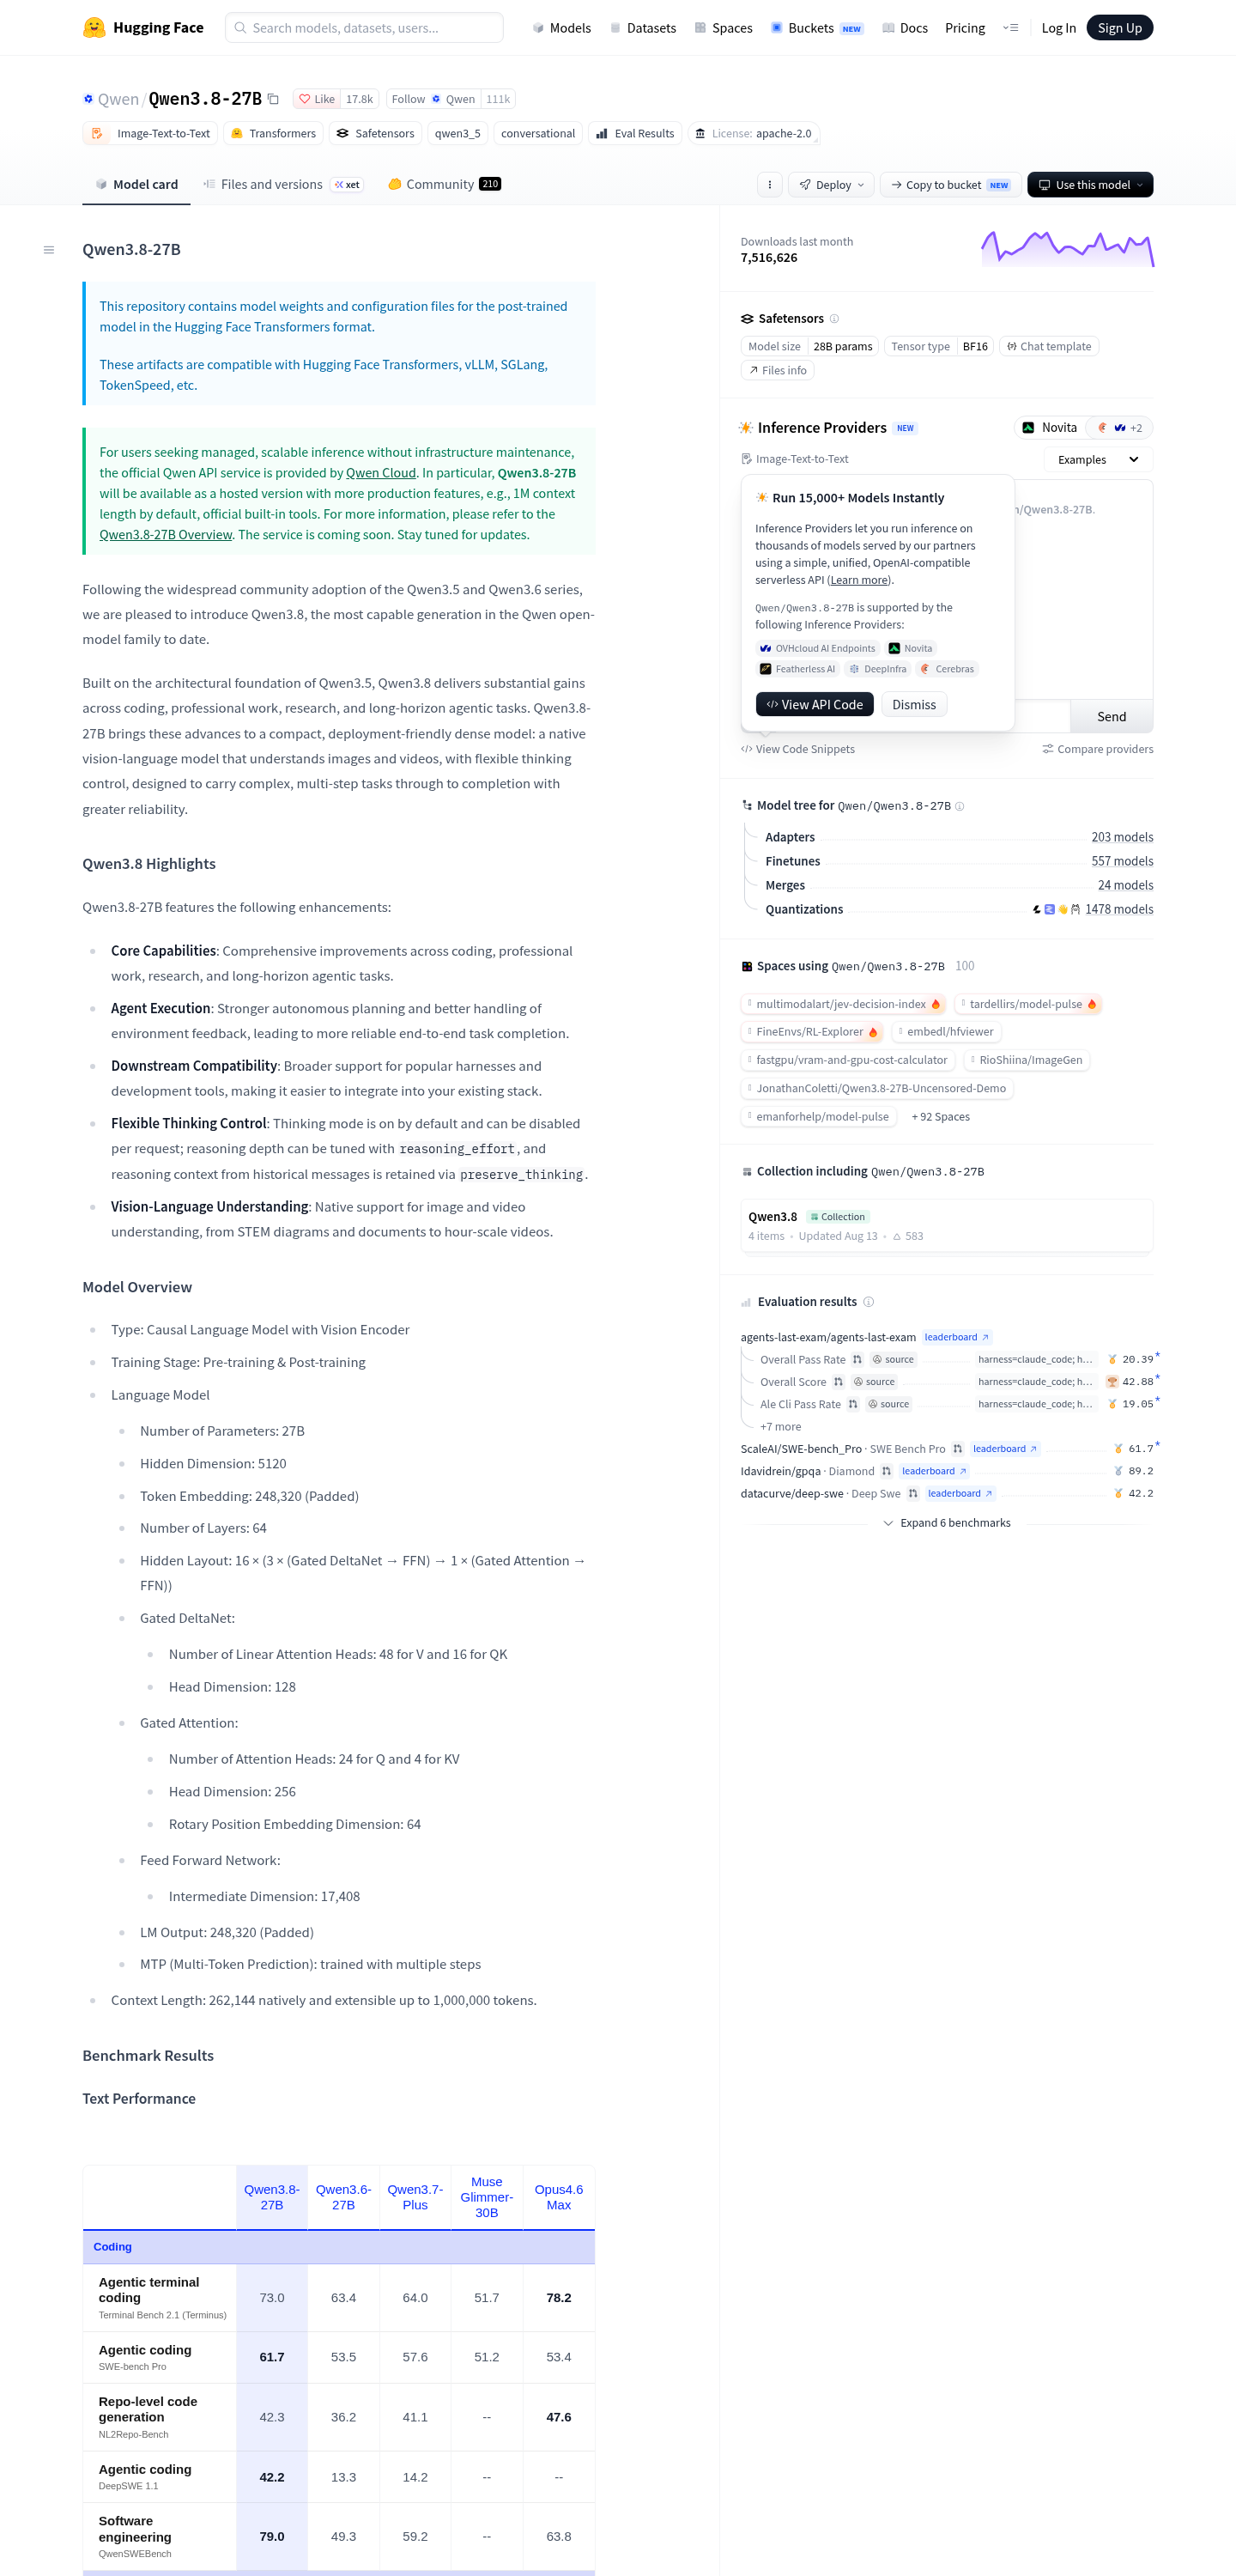
| Kiểu mô hình | Dense 27B đã lượng tử hóa 1-bit | Dense 27B (28B nếu tính tháp thị giác) |
| Định dạng trọng số | Gói nhị phân 1-bit | BF16 dense |
| Dung lượng tệp trọng số | 3,803 GB | 55,59 GB |
| Ngữ cảnh gốc | 262.144 token | 262.144 token, mở rộng tới 1.000.000 token |
| Đa phương thức | Văn bản (thừa hưởng từ Qwen3.6) | Ngôn ngữ–thị giác: hình ảnh, video |
| Giấy phép | Theo PrismML, trọng số mở | Apache 2.0, trọng số mở |
| Mục tiêu triển khai | Thiết bị biên, di động, máy yếu | Máy chủ, hạ tầng có GPU/CPU mạnh |
Bonsai 27B 1-bit: mô hình nhẹ 27B cho thiết bị biên
Bonsai 27B 1-bit là bản tái xây dựng từ Qwen3.6-27B với trọng số được lượng tử hóa xuống gói nhị phân 1-bit, dung lượng chỉ 3,803 GB. Theo mô tả từ PrismML, đây là cùng một mạng 27B với ngữ cảnh 262K, nhưng được nén tối đa để ưu tiên nén mô hình AI và hiệu suất thiết bị biên. Việc giảm từ hàng chục GB xuống dưới 4 GB mở ra khả năng chạy trên laptop phổ thông, mini PC, thậm chí một số thiết bị di động cao cấp, nơi bộ nhớ và băng thông lưu trữ là rào cản lớn nhất. Đánh đổi rất rõ: lượng tử hóa LLM ở mức 1-bit sẽ làm giảm độ chính xác và độ ổn định output so với bản dense hoặc ternary cùng nền tảng. PrismML thừa nhận bản ternary Bonsai 27B nặng hơn khoảng 7,165 GB nhưng lấy lại “chừng năm điểm chất lượng” so với 1-bit. Điều này cho thấy Bonsai 1-bit phù hợp với người dùng chấp nhận chất lượng thấp hơn để đổi lấy khả năng tự lưu trữ, độ trễ suy luận thấp trên CPU và chi phí hạ tầng gần như bằng không, đặc biệt trong các ứng dụng nội bộ, chatbot đơn giản hoặc tác vụ sinh văn bản không quá nhạy cảm.
Qwen 3.8 27B: hiệu suất đa phương thức và suy luận sâu trên máy chủ
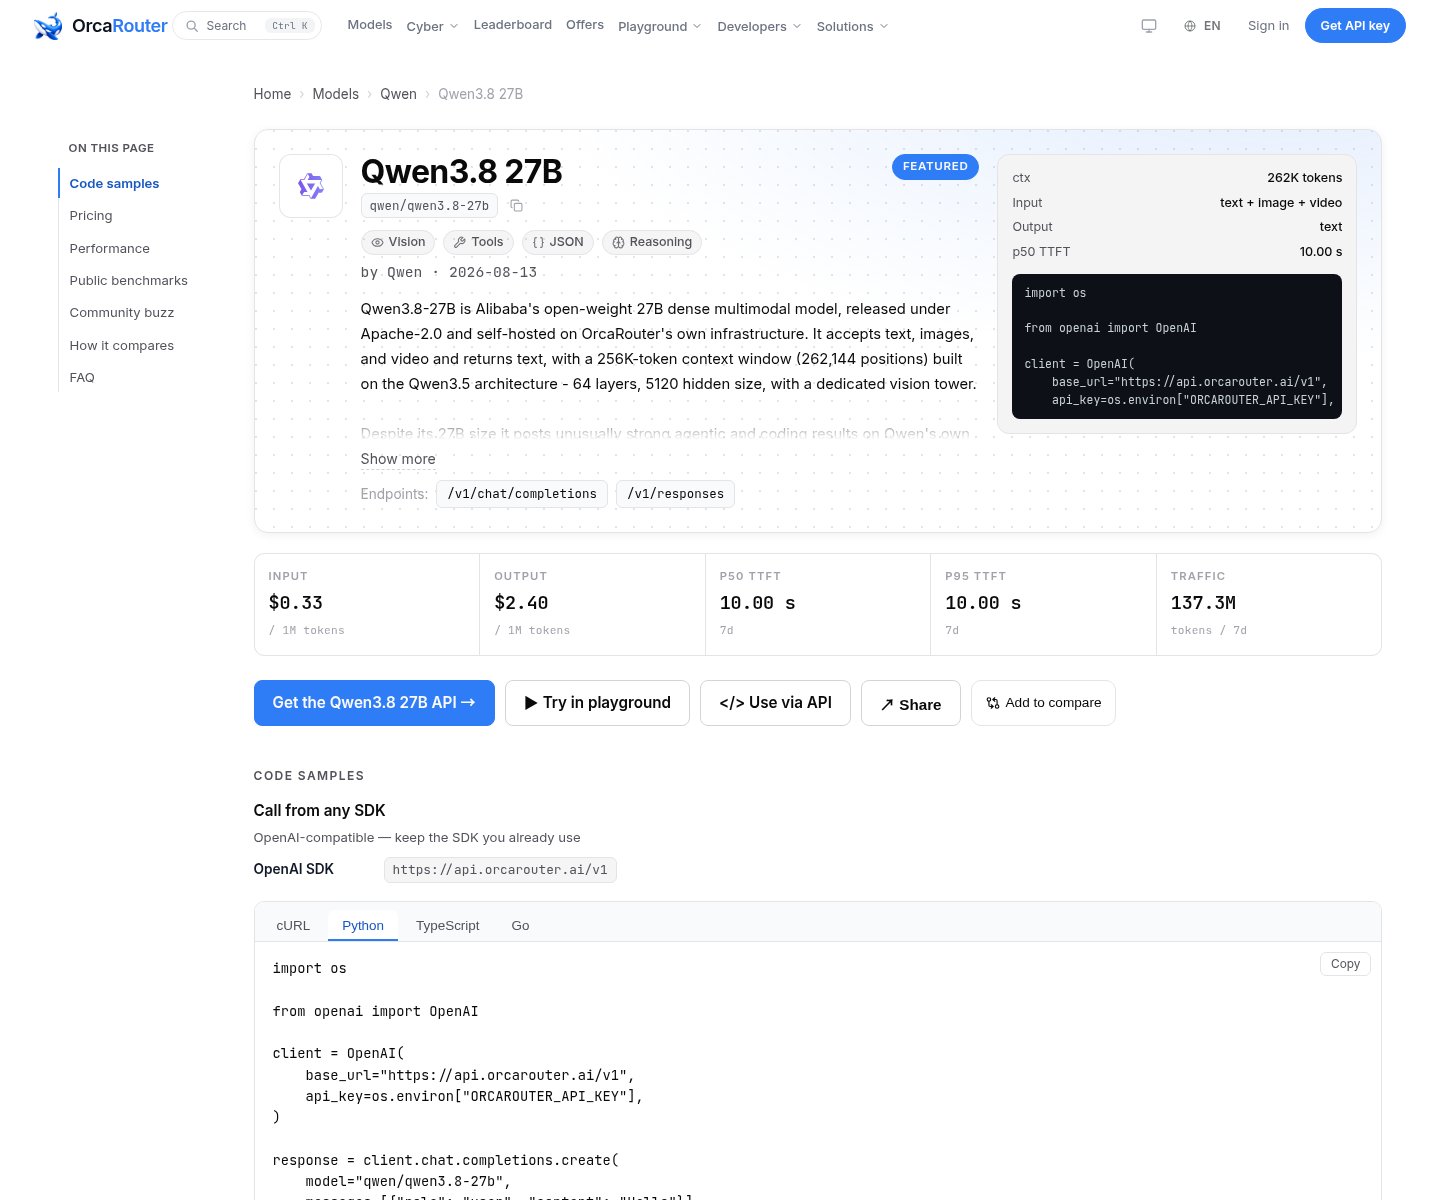
Qwen3.8-27B là mô hình dense 27 tỷ tham số của Alibaba, trọng số mở theo Apache 2.0 và nặng 55,59 GB ở định dạng BF16, trải trên mười tám shard safetensors. Thẻ mô hình gọi đây là “mô hình dense nhỏ gọn, thân thiện với triển khai”, nhưng rõ ràng nó nhắm tới máy chủ hơn là thiết bị biên: kích thước này đòi hỏi GPU hoặc CPU nhiều RAM, cùng băng thông lưu trữ ổn định. Điểm khác biệt lớn so với Bonsai là khả năng đa phương thức; Qwen 3.8 có một nhánh thị giác chuyên dụng, hiểu được hình ảnh và video, và được thiết kế để hoàn thành các tác vụ phức tạp, nhiều bước với độ tin cậy cao hơn. Kiến trúc của Qwen 3.8 dùng mười sáu khối lặp lại gồm ba lớp attention tuyến tính Gated Delta và một lớp Gated Attention đầy đủ, tổng cộng 64 lớp với chiều ẩn 5.120. Chỉ một trong bốn lớp giữ KV-cache, giúp mô hình dense 27B mang cửa sổ 262.144 token với chi phí bộ nhớ thấp hơn transformer tiêu chuẩn, và có thể mở rộng tới 1.000.000 token bằng YaRN. Theo Alibaba, Qwen3.8-27B đạt 90,3 trên LiveCodeBench v6 và 89,2 trên GPQA Diamond, cho thấy chất lượng suy luận và lập trình cao, phù hợp với hệ thống agent, trợ lý lập trình, phân tích tài liệu dài và ứng dụng pháp lý.
Đánh đổi lượng tử hóa: kích thước, độ trễ và chất lượng output
Sự khác biệt 3,803 GB so với 55,59 GB không chỉ là con số trên ổ cứng; đó là hai triết lý lượng tử hóa LLM đối nghịch. Bonsai 27B 1-bit chấp nhận nén cực mạnh để giảm kích thước và chi phí suy luận, trong khi Qwen 3.8 giữ BF16 dense nhằm bảo toàn chất lượng và tính ổn định. Trên thiết bị biên, Bonsai có lợi thế rõ rệt: tải nhanh, ít tốn RAM, có thể chạy trên CPU với batch nhỏ mà vẫn cho độ trễ suy luận chấp nhận được. Ngược lại, Qwen 3.8 cần hạ tầng mạnh hơn, nhưng đổi lại là output nhất quán hơn, khả năng đa phương thức và ngữ cảnh dài vượt trội. Các bản lượng tử hóa khác nhau ảnh hưởng trực tiếp tới độ chính xác và độ trễ: càng ít bit, mô hình càng nhẹ và nhanh, nhưng sai số lượng tử hóa tích lũy khiến câu trả lời dễ trôi, mất chi tiết hoặc kém tin cậy trong tác vụ khó. Người triển khai cần cân nhắc: với chatbot nội bộ, ứng dụng ngoại tuyến, hoặc môi trường không có GPU, Bonsai là lựa chọn thực tế; với sản phẩm hướng người dùng cuối, yêu cầu chất lượng cao, hiểu hình ảnh, video hoặc tích hợp agent phức tạp, Qwen 3.8 nên là mô hình gốc, có thể được lượng tử hóa nhẹ hơn (FP8, NVFP4, GGUF…) mà vẫn giữ phần lớn sức mạnh.
Buy if / Skip if
- Buy the Bonsai 27B 1-bit if bạn cần mô hình nhẹ 27B chạy trên thiết bị biên, di động hoặc máy không có GPU, chấp nhận đánh đổi chất lượng để lấy kích thước 3,803 GB và độ trễ thấp.
- Skip the Bonsai 27B 1-bit if bạn làm tác vụ phức tạp, cần độ chính xác cao, hoặc xây sản phẩm hướng người dùng cuối nơi chất lượng output và ổn định quan trọng hơn khả năng chạy trên phần cứng yếu.
- Buy the Qwen 3.8 27B if bạn cần mô hình dense đa phương thức hiểu hình ảnh, video, ngữ cảnh dài tới hàng trăm nghìn token, và có hạ tầng máy chủ đủ mạnh để gánh trọng số 55,59 GB.
- Skip the Qwen 3.8 27B if bạn triển khai trên môi trường ngoại tuyến hạn chế RAM, không thể lưu trữ gói BF16 lớn, hoặc chỉ cần chatbot văn bản đơn giản không tận dụng được tháp thị giác và suy luận sâu.