
Không có một mô hình thắng mọi cuộc kiểm tra
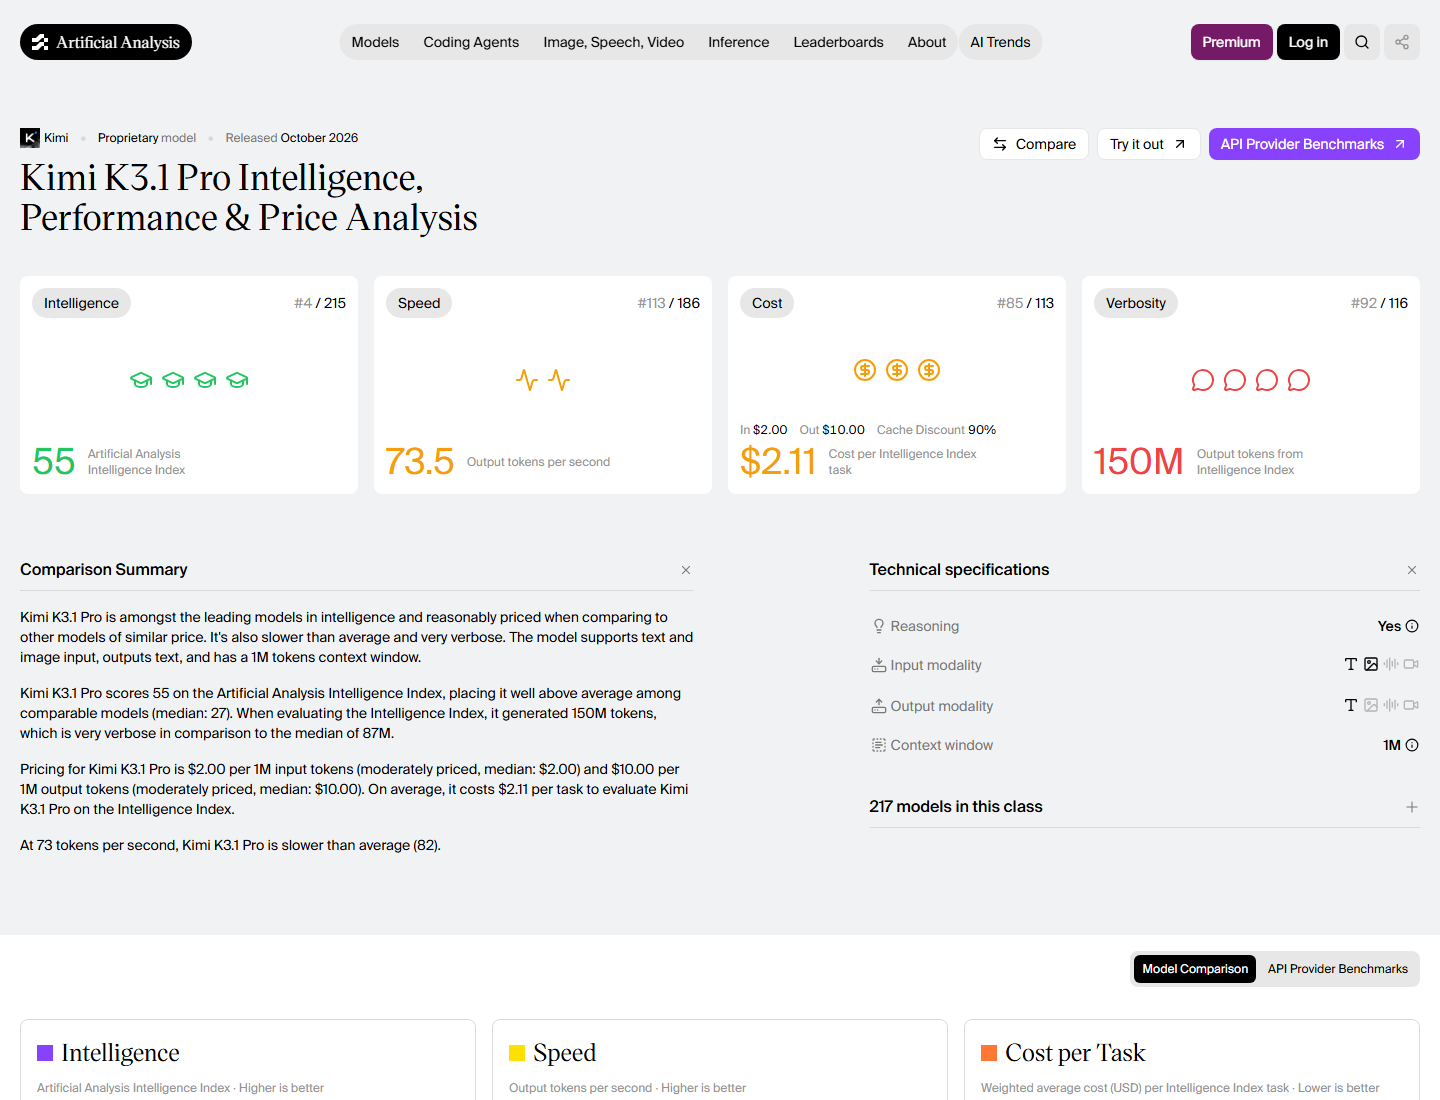
Kimi K3.1 Pro và GPT-6 Astra là hai mô hình AI đầu bảng có cửa sổ ngữ cảnh xấp xỉ một triệu token, nhưng khác nhau về giá, giới hạn đầu ra và kết quả theo từng bài đánh giá. Điểm benchmark AI tổng hợp không thể thay thế việc xem mô hình nào làm tốt công việc bạn cần. Trên chỉ số độc lập của Artificial Analysis, Kimi đạt 55 điểm, cao hơn GPT-6 Astra với 53 điểm. Tuy nhiên, khoảng cách nhỏ ấy không chứng minh Kimi luôn mạnh hơn: các bài kiểm tra do nhà phát triển công bố cho thấy Astra vượt trội ở CAD và giảm ảo giác, còn Kimi dẫn ở Terminal-Bench. Giá mô hình AI của Kimi thấp hơn đáng kể, nhưng hiệu quả thực tế còn tùy lượng đầu ra, tốc độ phản hồi và độ chính xác cần thiết. Vì vậy, chọn chỉ theo giá hoặc một điểm tổng là cách dễ đưa ra quyết định sai.
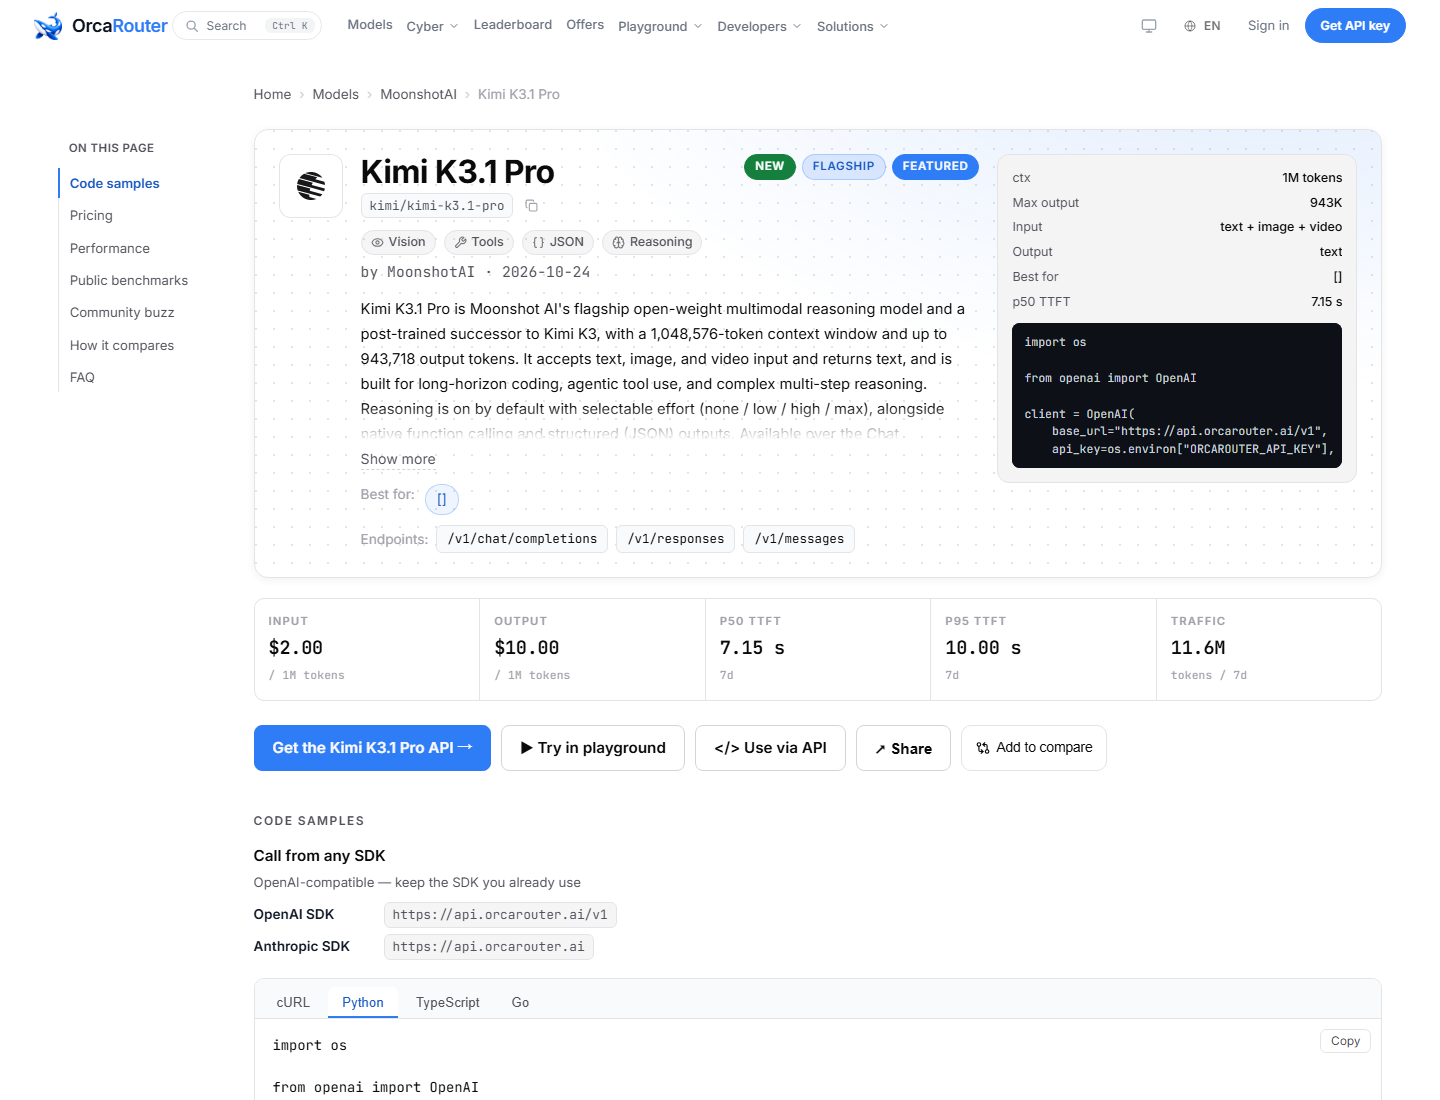
| Tiêu chí | Kimi K3.1 Pro | GPT-6 Astra |
|---|---|---|
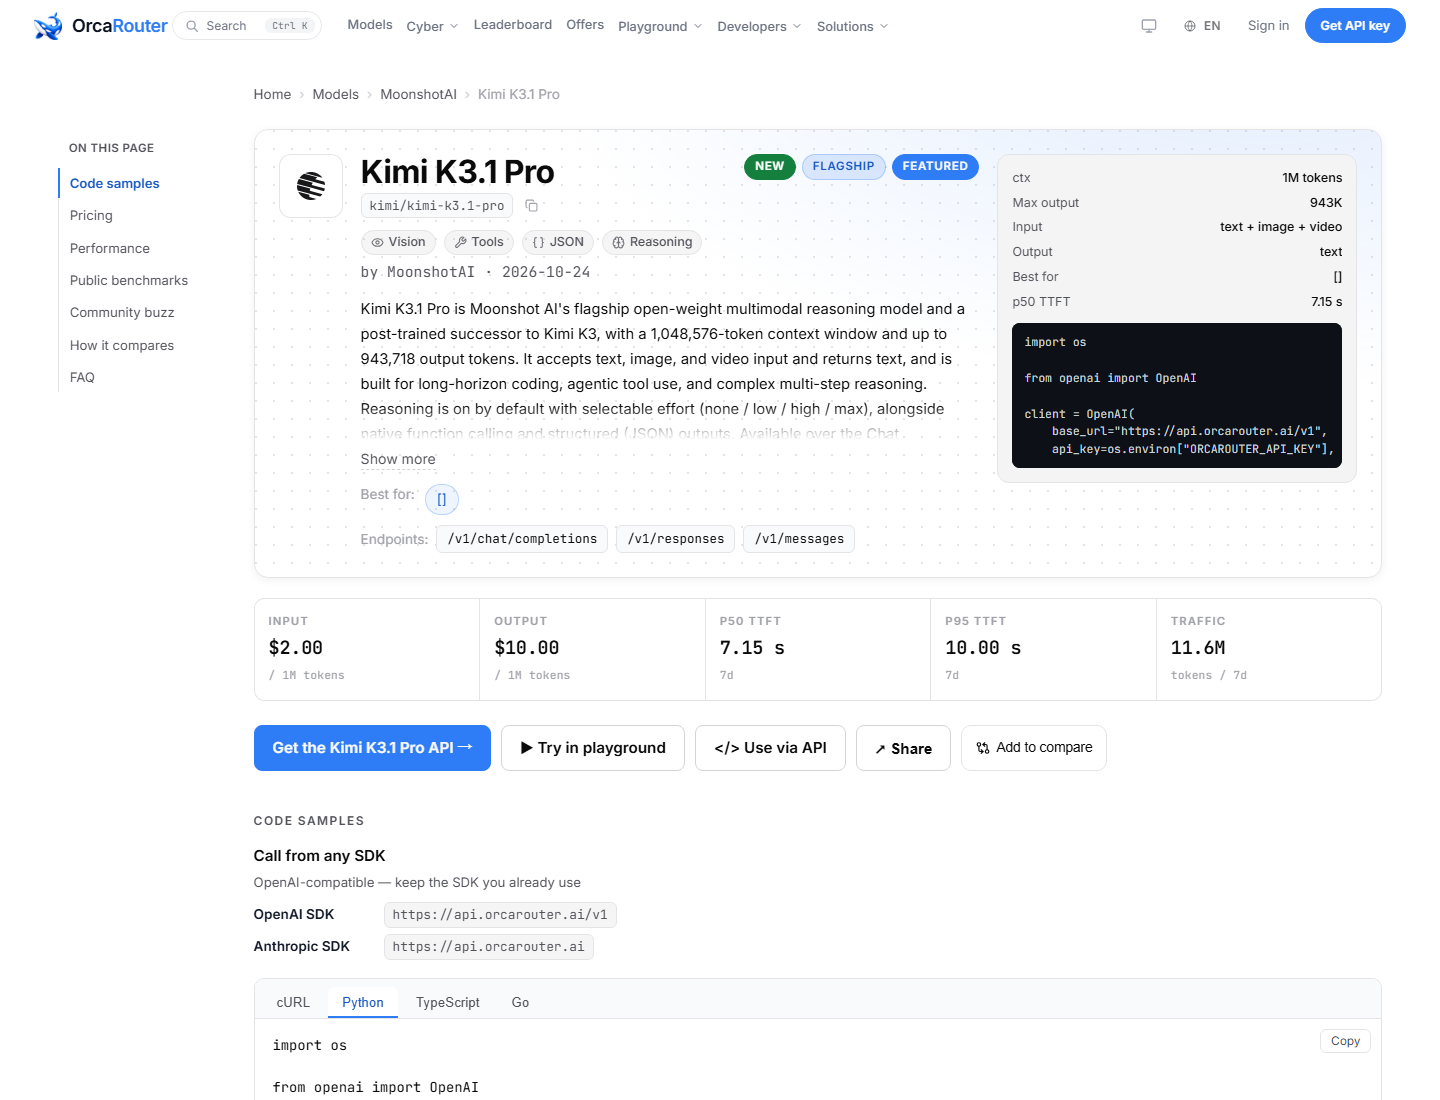
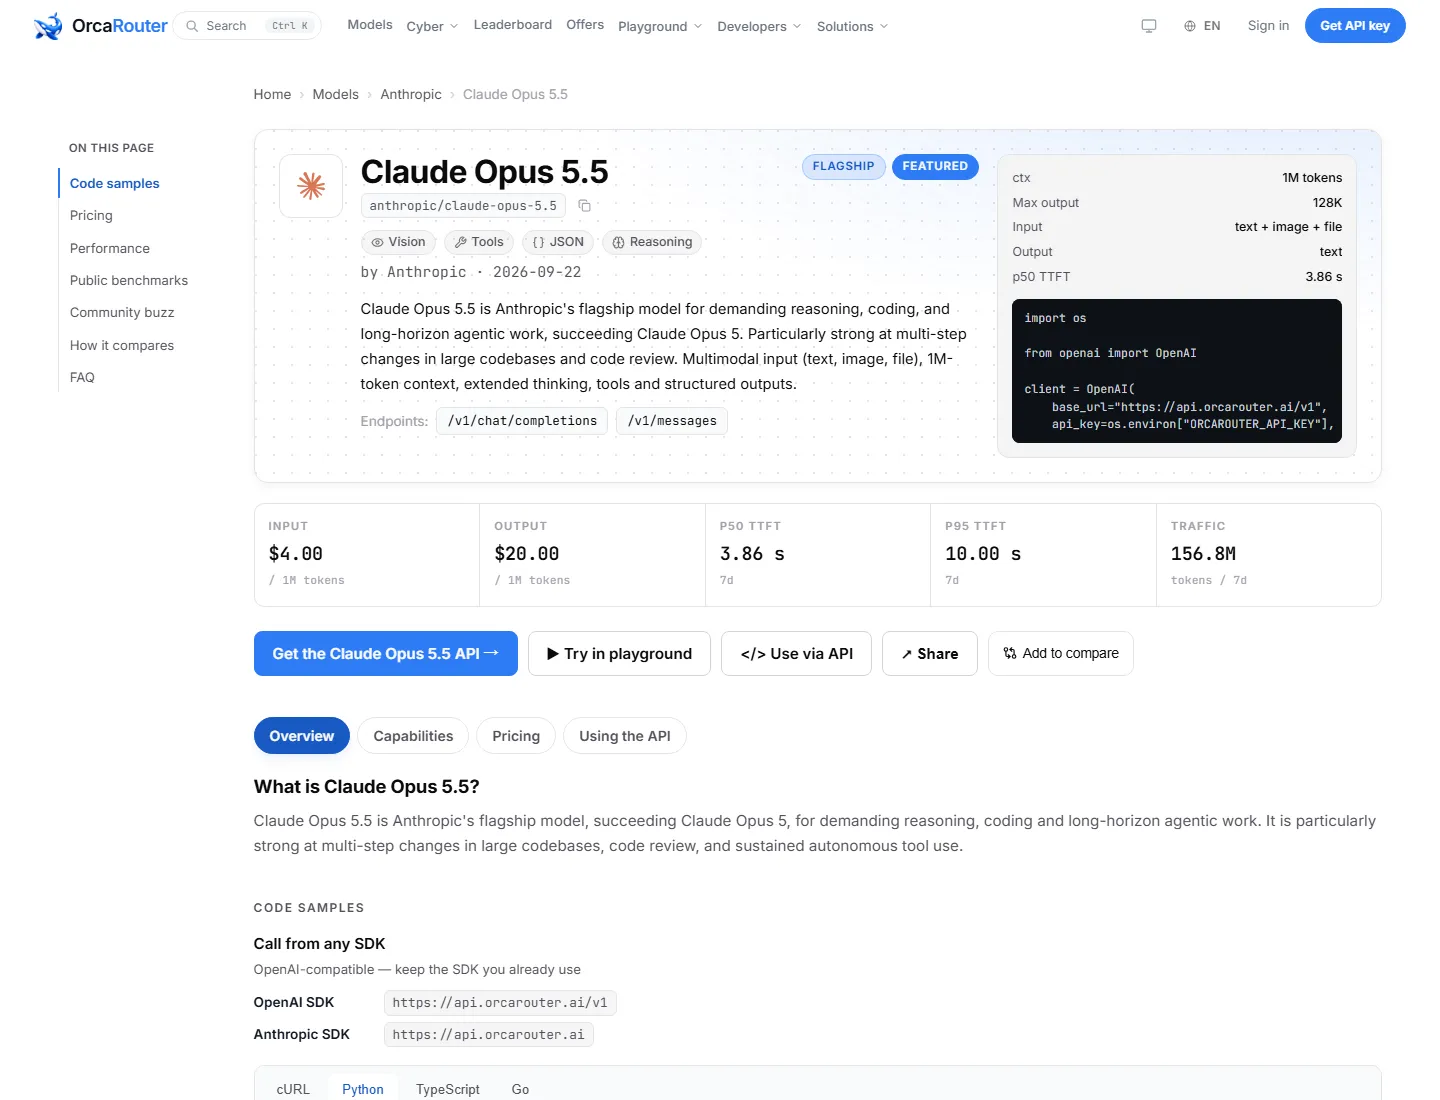
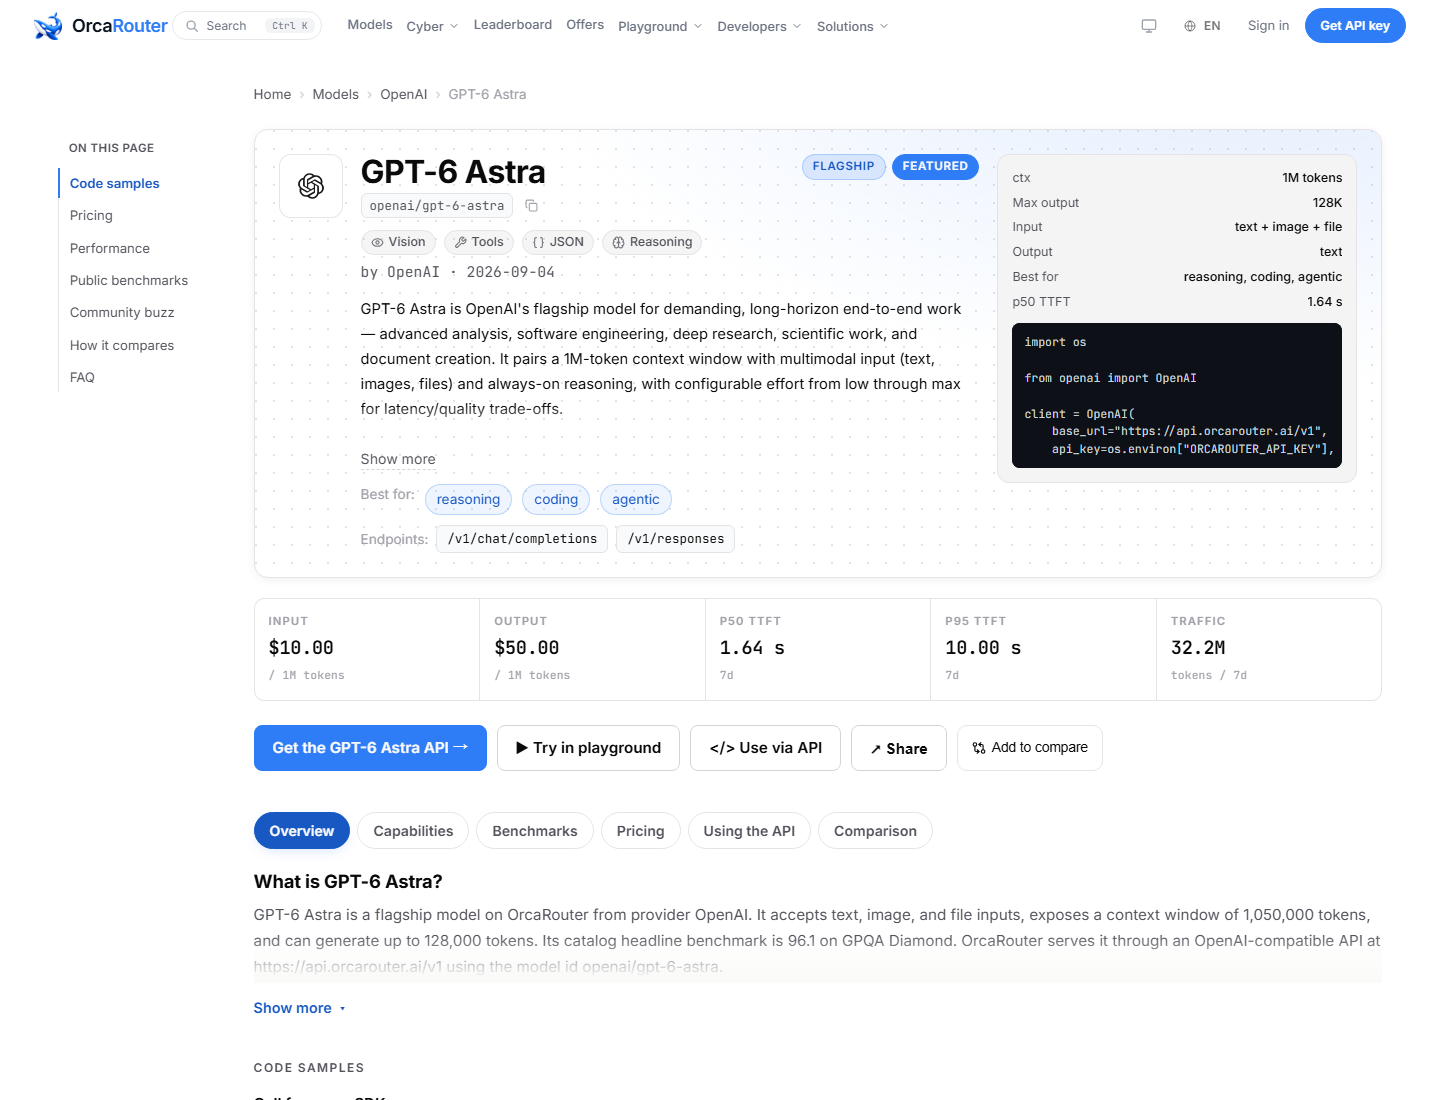
| Cửa sổ ngữ cảnh | 1.048.576 token | 1.050.000 token |
| Đầu ra tối đa | 943.718 token | 128.000 token |
| Giá đầu vào mỗi triệu token | 2 USD | 10 USD |
| Giá đầu ra mỗi triệu token | 10 USD | 50 USD |
| Chỉ số Intelligence của Artificial Analysis | 55 | 53 |
| Tốc độ đầu ra trong đánh giá độc lập | 73,5 token/giây | 58,1 token/giây |
| Thời gian trung vị đến token đầu tiên trên tuyến OrcaRouter | 7,15 giây | 1,64 giây |
Kimi dẫn ở tác vụ dài, Astra chắc tay hơn ở CAD và độ chính xác
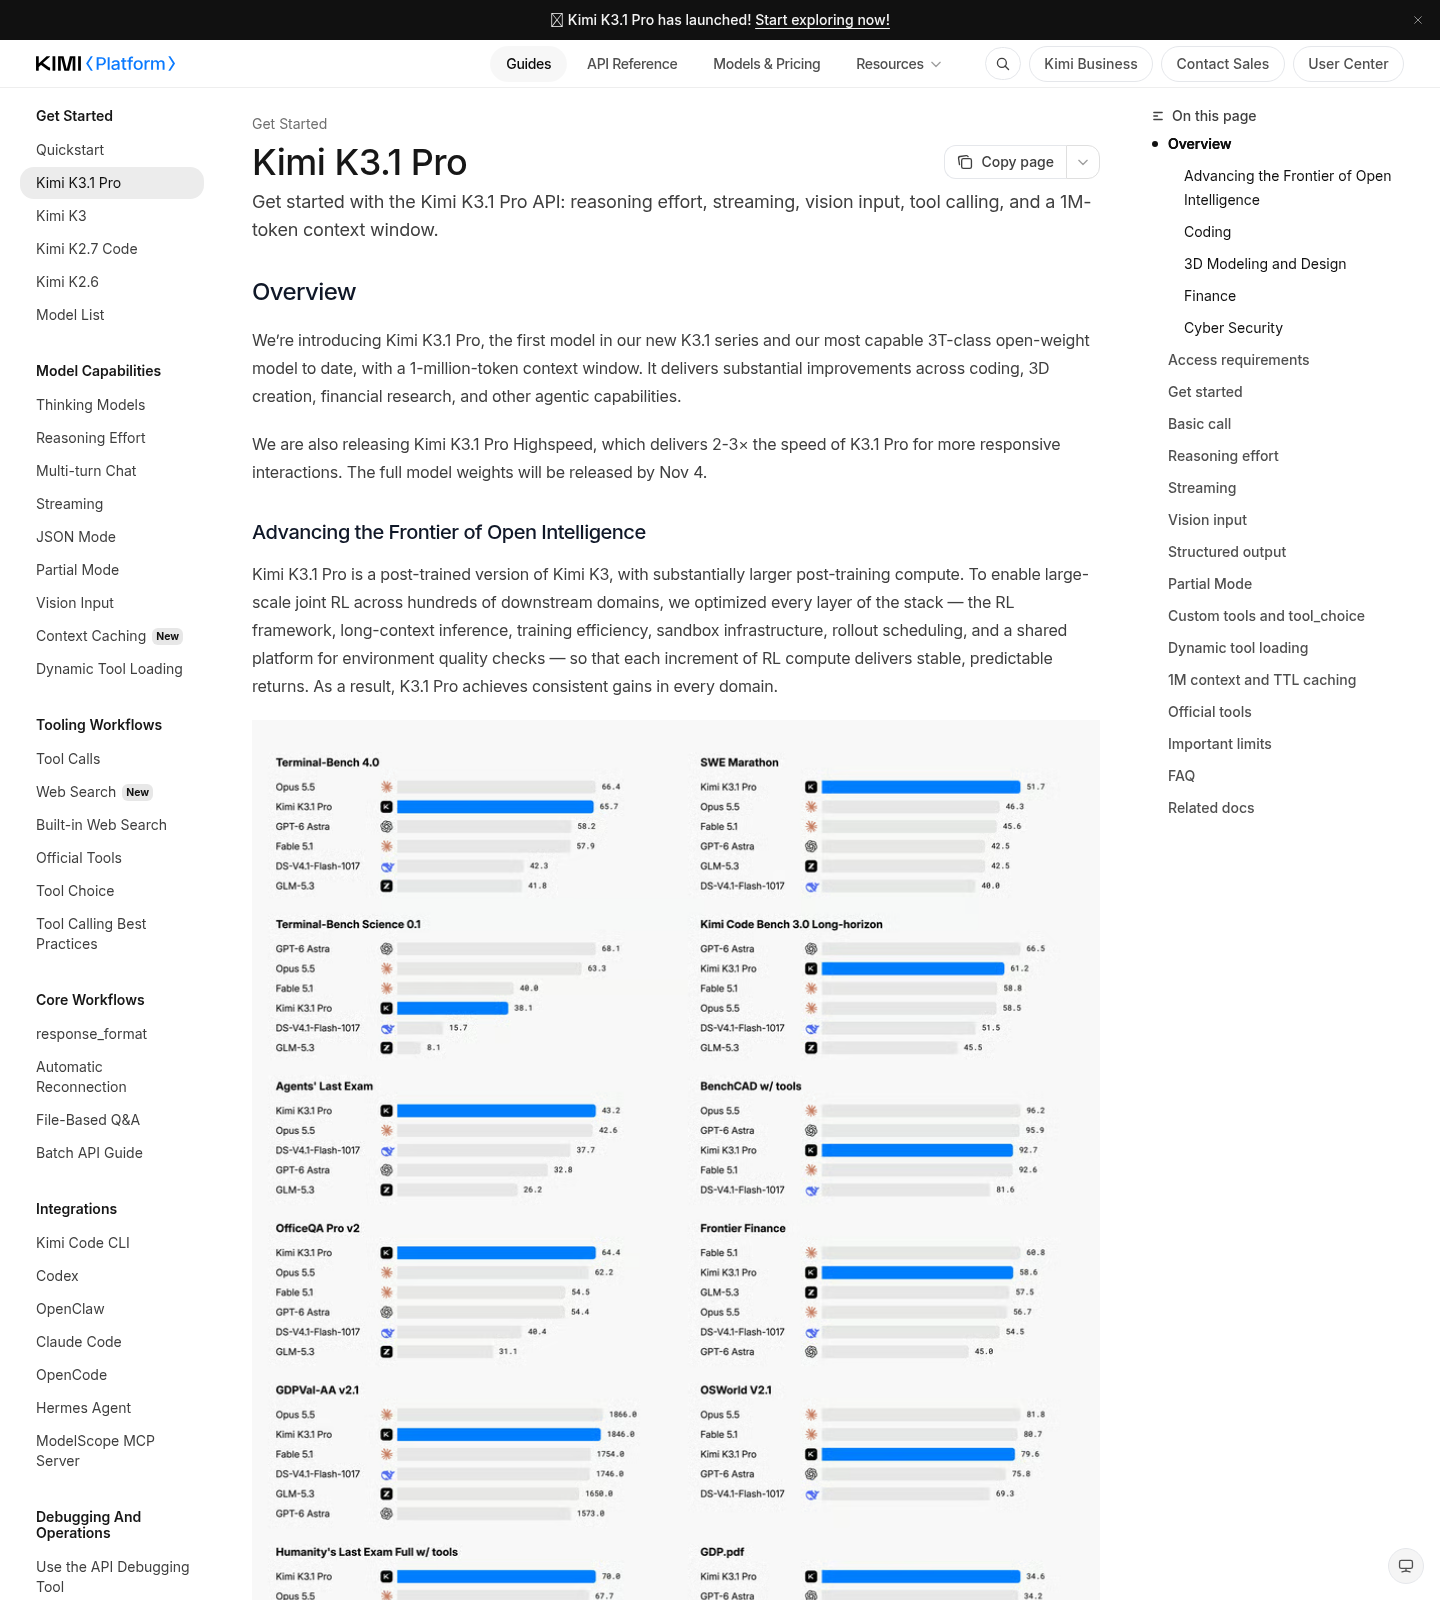
Ở Terminal-Bench 4.0, số liệu do nhà phát triển công bố cho Kimi là 65,7%, so với 58,2% của GPT-6 Astra: lợi thế 7,5 điểm cho Kimi trong bài kiểm tra thiên về tác vụ terminal và lập trình agent. Nhưng ở BenchCAD có công cụ, cán cân đổi chiều: Kimi đạt 92,7%, còn Astra đạt 95,9%, hơn 3,2 điểm. Khác biệt đáng chú ý hơn với công việc nghiên cứu là tỷ lệ ảo giác trong Kimi Hallu Bench Hard: khi dùng công cụ, Kimi ở mức 8,3% so với 5,5% của Astra; không dùng công cụ, lần lượt là 5,4% và 4,2%. Tỷ lệ thấp hơn có ý nghĩa khi cần kiểm chứng tài liệu, nơi một câu trả lời bịa đặt gây thiệt hại lớn hơn vài giây chờ đợi. Kết luận hợp lý không phải mô hình nào giỏi hơn tuyệt đối, mà là Kimi hợp với tác vụ terminal dài còn Astra đáng cân nhắc cho CAD và kiểm chứng.
Mức giá theo token khiến Kimi trông rẻ hơn rất nhiều, nhưng tổng chi phí không giảm cùng tỷ lệ. Trong phép đo của Artificial Analysis, Kimi tốn 2,11 USD cho mỗi tác vụ Intelligence Index, còn Astra là 3,26 USD, tương ứng khoản tiết kiệm 35%. Kimi tạo 150 triệu token đầu ra trong lần chạy đánh giá, so với 60 triệu của Astra; sự dài dòng bào mòn một phần lợi thế giá. Điều này nhắc người mua nhìn vào chi phí mỗi tác vụ thay vì chỉ so bảng giá đầu vào và đầu ra.
Nguồn chấm và thiết lập có thể đổi thứ tự xếp hạng
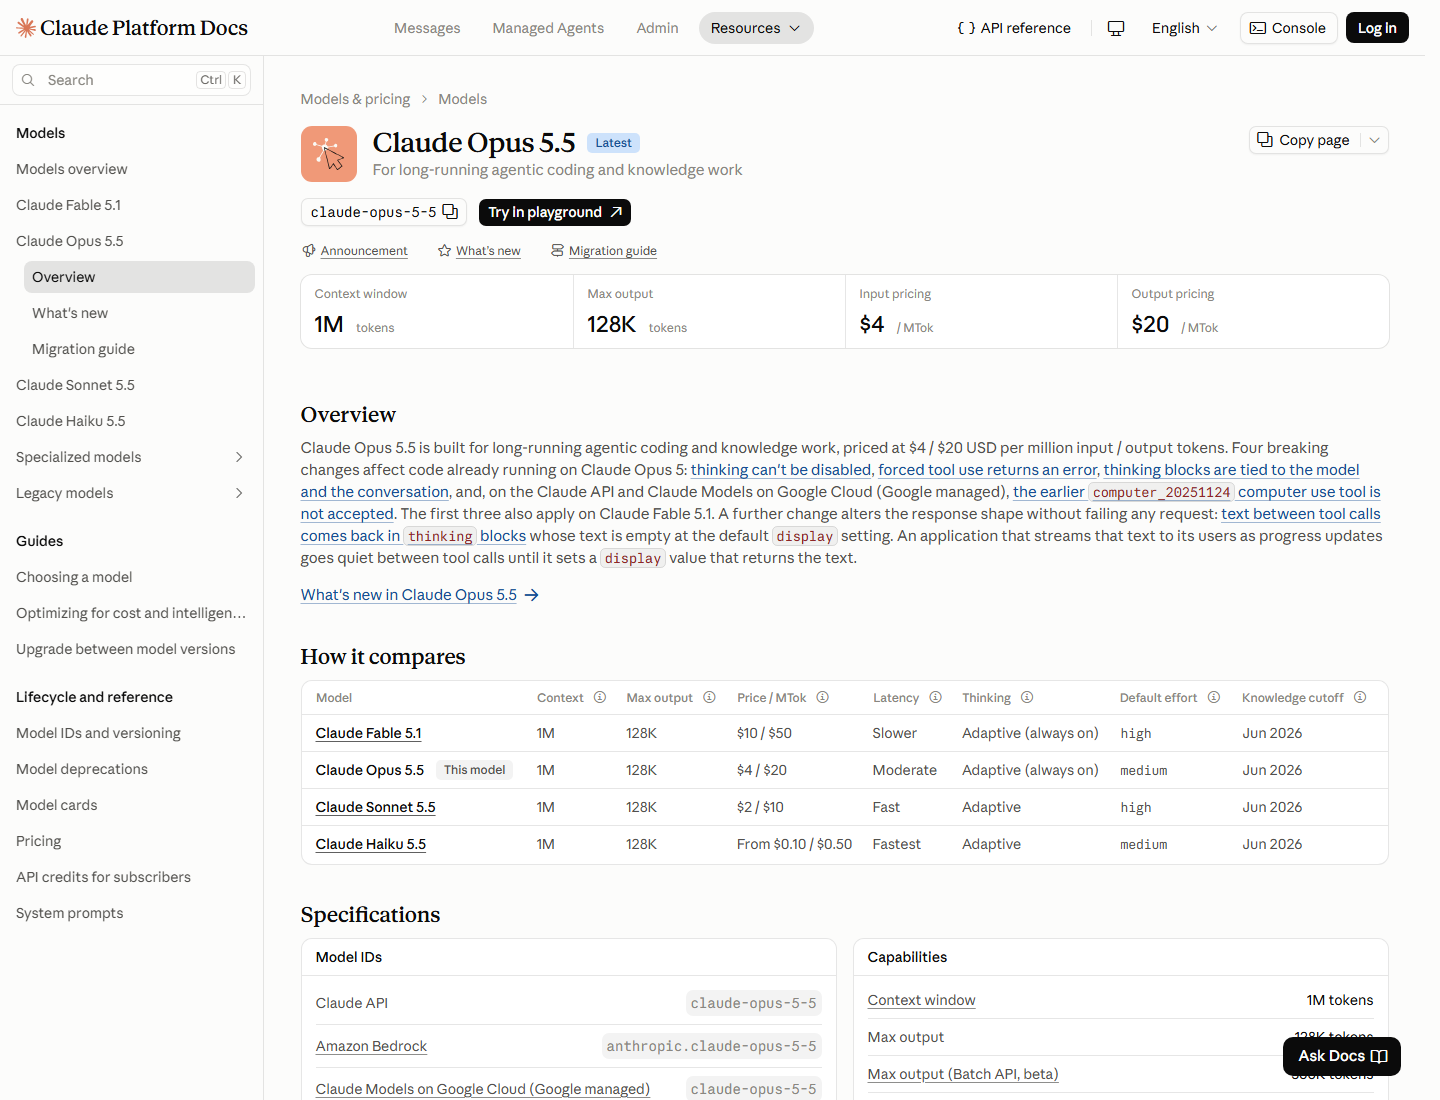
Điểm benchmark không phải phép đo thuần túy tách khỏi cách chạy thử. Artificial Analysis tự thực hiện bộ Intelligence Index, gộp nhiều đánh giá thành một điểm; bảng của Moonshot lại công bố các kết quả riêng, gồm Terminal-Bench. Khung đánh giá, công cụ đi kèm và mức nỗ lực suy luận đều có thể làm kết quả đổi khác. Chẳng hạn, kết quả Terminal-Bench của Claude Opus 5.5 được công bố ở mức xhigh effort, trong khi lần chạy Kimi dùng mức mặc định max; các thiết lập và bộ khung không hoàn toàn đồng nhất. Vì thế, không nhất thiết một nguồn sai: chúng có thể đang trả lời những câu hỏi khác nhau. Bảng do nhà phát triển công bố có ích để xem mô hình thể hiện ra sao trên các bài họ chọn, nhưng cần đọc cùng điều kiện thử nghiệm; đánh giá độc lập giúp đối chiếu trên một hệ thống chung, song điểm tổng vẫn có thể che khuất điểm yếu theo nhiệm vụ.
Dữ liệu còn thiếu cũng giới hạn quyết định mua. Tài liệu của Moonshot không đưa ra điểm số cụ thể cho Kimi trên Terminal-Bench-Science 0.1, chỉ nói kết quả cao hơn phiên bản K3. Bài giới thiệu cũng nhắc SWE-bench trong chú thích nhưng không công bố điểm, dù đây là thước đo thường được dùng để đánh giá coding agent. Ngoài ra, người dùng cần kiểm tra chi phí trên khối lượng công việc thực tế, lượng đầu ra mô hình tạo ra, độ trễ có thể chấp nhận và yêu cầu về trọng số hay quyền truy cập. Chi phí mỗi tác vụ của Artificial Analysis hữu ích hơn giá token để lập kế hoạch, nhưng vẫn không thay thế phép thử với tác vụ của chính bạn.
Chọn theo việc cần làm, đừng di chuyển chỉ vì một điểm số
- Mua nếu phần lớn công việc là tác vụ terminal dài hoặc lập trình agent, nơi Kimi dẫn Terminal-Bench và có giới hạn đầu ra tối đa lớn hơn.
- Bỏ qua nếu luồng làm việc cần phản hồi ban đầu nhanh: thời gian trung vị đến token đầu tiên được ghi nhận cho Astra thấp hơn đáng kể.
- Mua nếu bạn làm CAD hoặc cần ưu tiên kiểm chứng tài liệu và giảm ảo giác; các kết quả được công bố nghiêng về GPT-6 Astra ở những bài này.
- Bỏ qua nếu bạn định chuyển toàn bộ khối lượng công việc chỉ vì Kimi có giá token thấp hơn; độ dài đầu ra có thể làm giảm khoản tiết kiệm.
- Mua sau khi chạy thử trên tác vụ thực tế, đo cả độ chính xác, độ trễ lẫn chi phí mỗi việc hoàn thành.
Kimi K3.1 Pro hấp dẫn khi cần xử lý tác vụ dài với chi phí thấp hơn, còn GPT-6 Astra đáng giá hơn ở những việc mà độ chính xác CAD, khả năng hạn chế ảo giác và phản hồi nhanh quan trọng. Cả hai đều có những giới hạn riêng, và bảng điểm hiện có chưa cung cấp đủ dữ liệu cho mọi tình huống sử dụng. Hãy chọn theo nhóm tác vụ, thử nghiệm song song và tính chi phí trên công việc hoàn tất; đừng chuyển hệ thống chỉ vì một dòng benchmark.