
Đừng chọn bằng tai trước khi xét cách triển khai
Mô hình AI âm thanh là hệ thống xử lý lời nói để nhận dạng, tạo giọng nói hoặc thực hiện cả hai, nhưng giá trị trong sản phẩm phụ thuộc vào cách truy cập, độ trễ và quyền triển khai chứ không chỉ chất lượng âm thanh. Với tổng đài, phụ đề trực tiếp hay trợ lý hội thoại, khả năng truyền phát có thể quan trọng hơn vài điểm chênh trong độ chính xác.
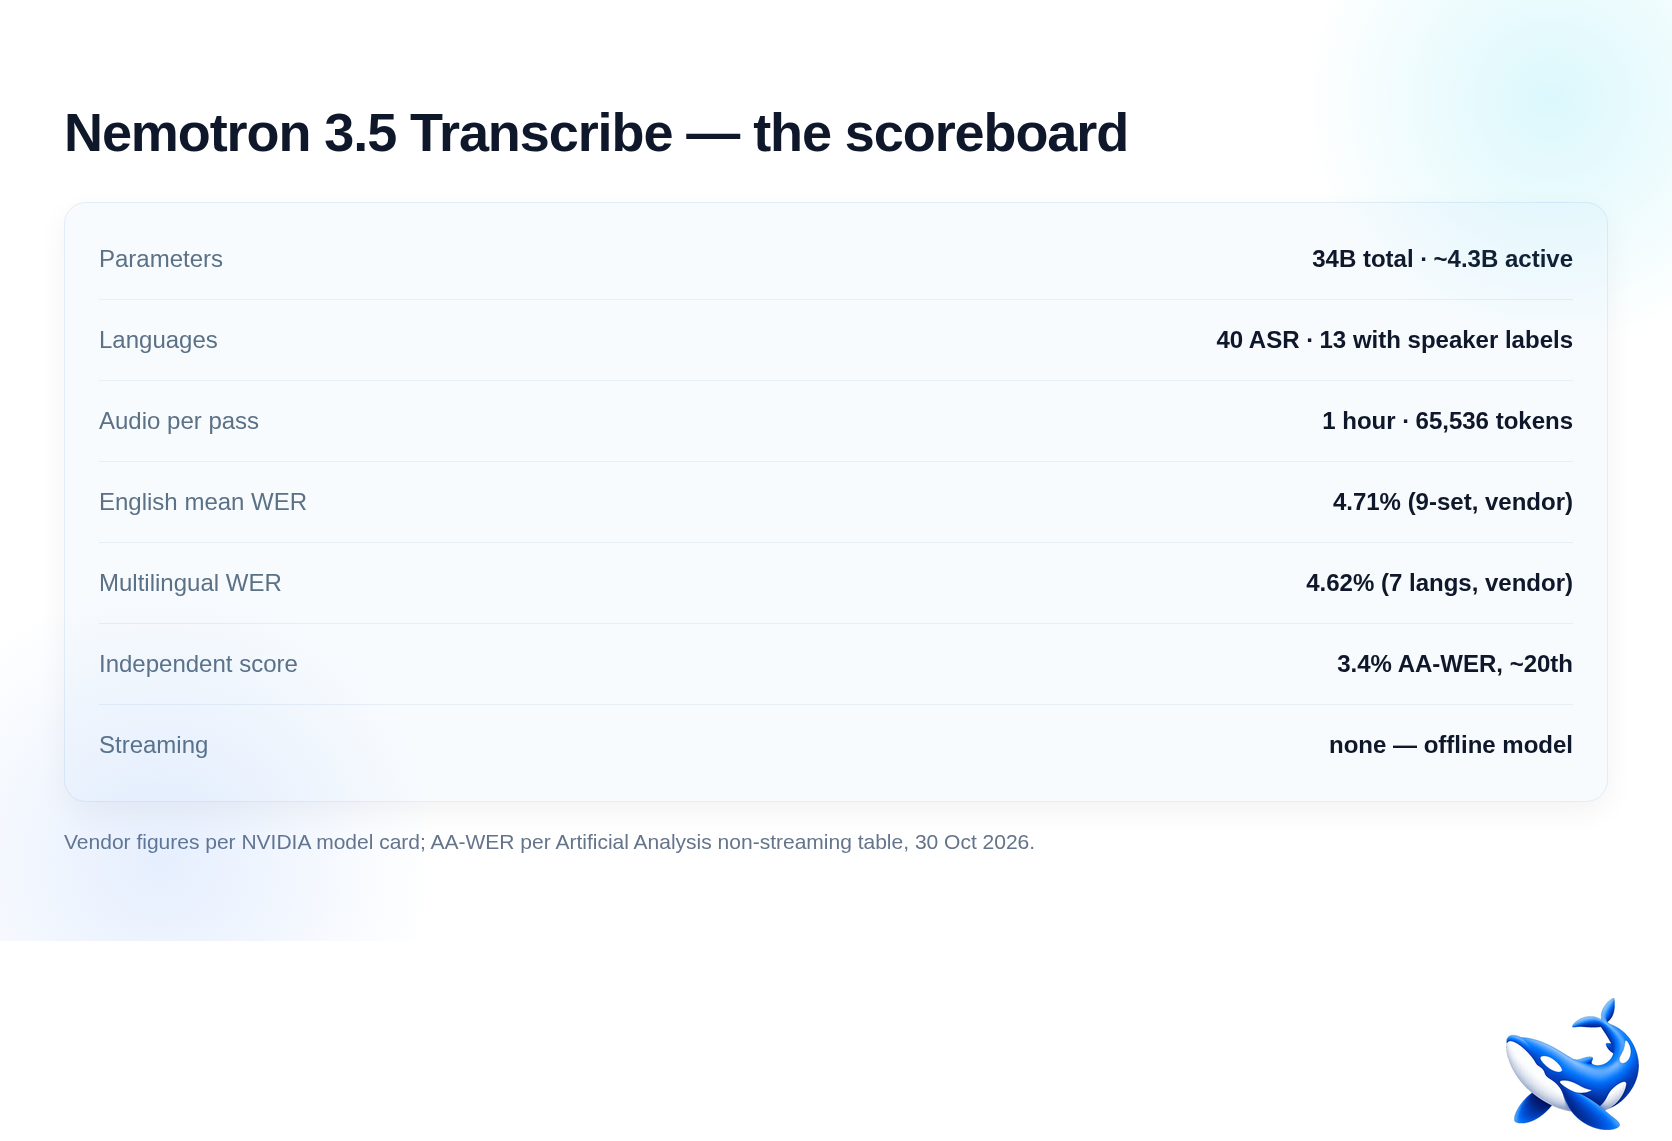
Grok Voice Transcribe 2.0 là dịch vụ có API REST và WebSocket, trả kết quả tạm thời khoảng mỗi 500 mili giây; Nemotron 3.5 Transcribe là checkpoint trọng số mở để tự vận hành, nhưng chỉ nhận tệp hoàn chỉnh và không có luồng truyền phát được ghi nhận. NVIDIA nêu hỗ trợ 40 ngôn ngữ, trong đó 13 ngôn ngữ có phiên âm nhiều người nói. Vì vậy, mô hình nhận dạng giọng nói cần phản hồi trong lúc người dùng đang nói nghiêng rõ về Grok; đội ngũ ưu tiên kiểm soát hạ tầng và phạm vi ngôn ngữ có thể cân nhắc Nemotron.
Khác biệt này không thể rút gọn thành bên nào “tốt hơn”. Grok phù hợp khi cần tích hợp nhanh và phản hồi tức thời; Nemotron hấp dẫn khi muốn tự lưu trữ, nhưng đòi hỏi năng lực phần cứng và vận hành. Đặc biệt, Nemotron không có chế độ truyền phát chỉ vì NVIDIA có một mô hình streaming khác trong danh mục.
Tự sở hữu mô hình hay chọn chất giọng có tiếng?
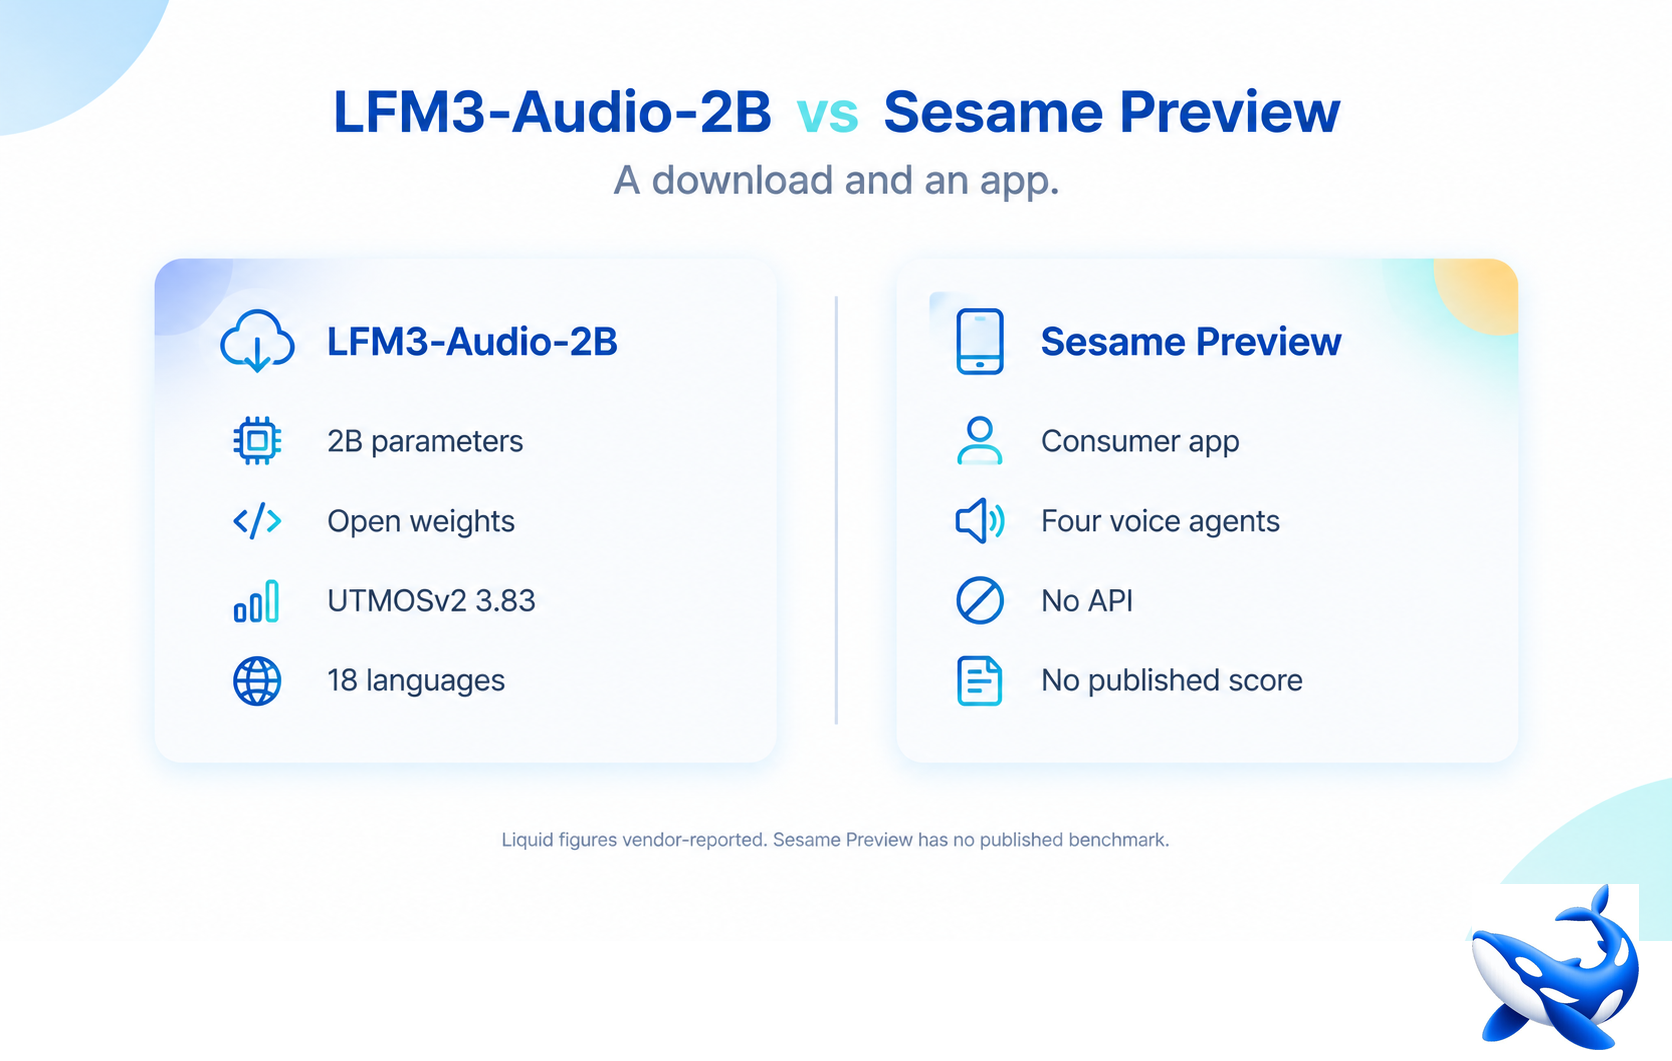
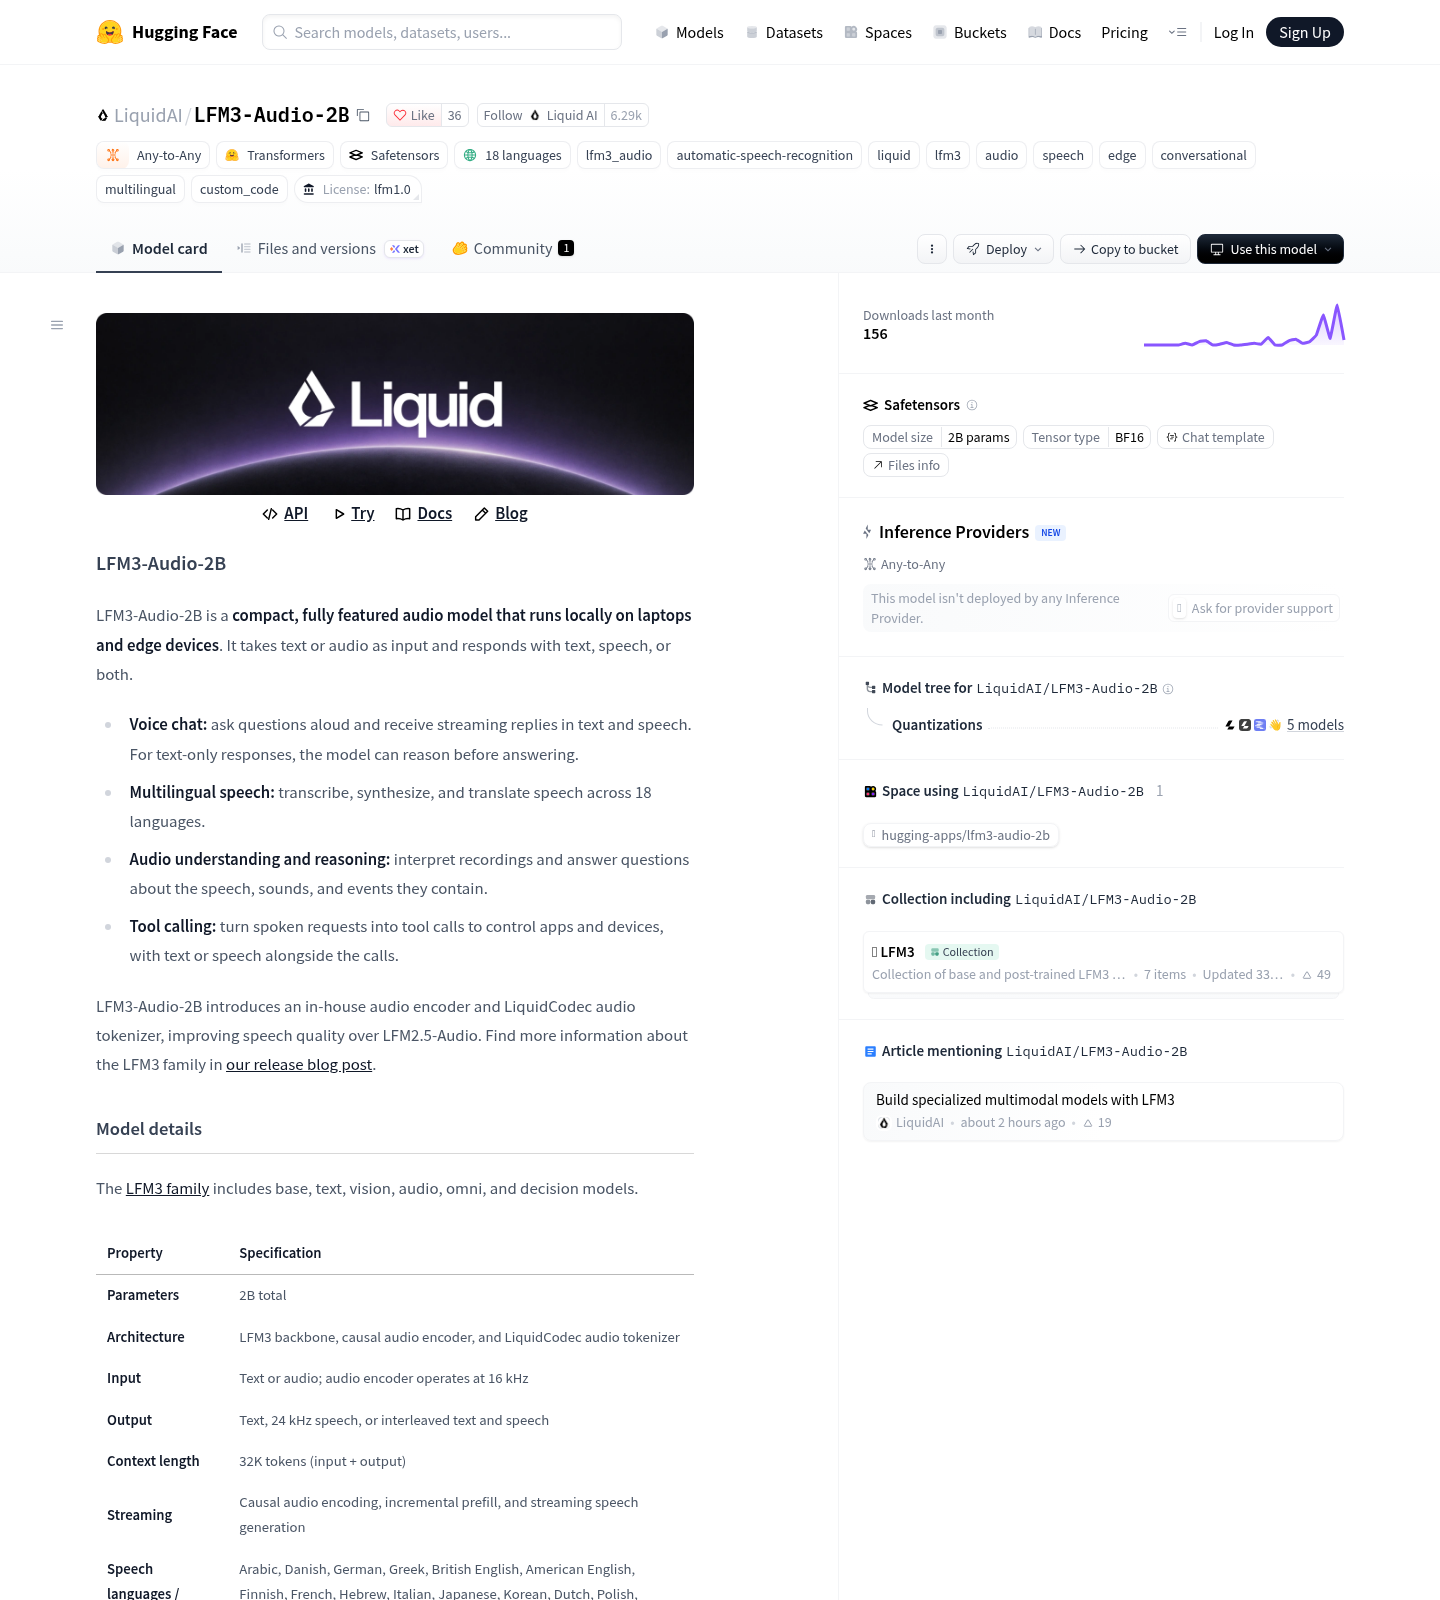
LFM3-Audio-2B và Sesame Preview minh họa rõ khoảng cách giữa một thành phần có thể đưa vào sản phẩm với một trải nghiệm người dùng ấn tượng nhưng đóng kín. LFM3-Audio-2B có thể tải xuống, chạy trên nhiều nền tảng và hỗ trợ đầu vào âm thanh hoặc văn bản cùng đầu ra tương ứng. Tuy nhiên, giấy phép LFM Open v1.0 gắn điều kiện thương mại với ngưỡng doanh thu, nên nhóm phát triển cần đọc kỹ điều khoản trước khi phát hành.
Sesame Preview được khen về chất giọng hội thoại, nhưng đó là ứng dụng tiêu dùng, không phải API tổng hợp giọng nói cho nhà phát triển: không có API công khai, mã mô hình hay bảng giá rõ ràng. Ấn tượng khi nghe không thay thế được phép thử trong sản phẩm. Nếu cần một giọng nói có thể bị ngắt lời, Sesame có lợi thế được mô tả; nếu cần tiếng Thụy Điển, tiếng Hà Lan hoặc chạy ngoại tuyến, LFM3 có cơ sở phù hợp hơn.
Cũng cần phân biệt Sesame Preview với CSM 1B. CSM 1B là checkpoint giọng nói hội thoại có giấy phép Apache 2.0, chứ không phải mô hình sản xuất đứng sau các persona trong ứng dụng. Chọn checkpoint đồng nghĩa tự xây dựng lớp phục vụ và agent; chọn endpoint có sẵn thường hợp lý hơn khi thiếu GPU hoặc kỹ sư phụ trách vận hành.
Giọng nói có thể mua và giọng nói chưa thể gọi
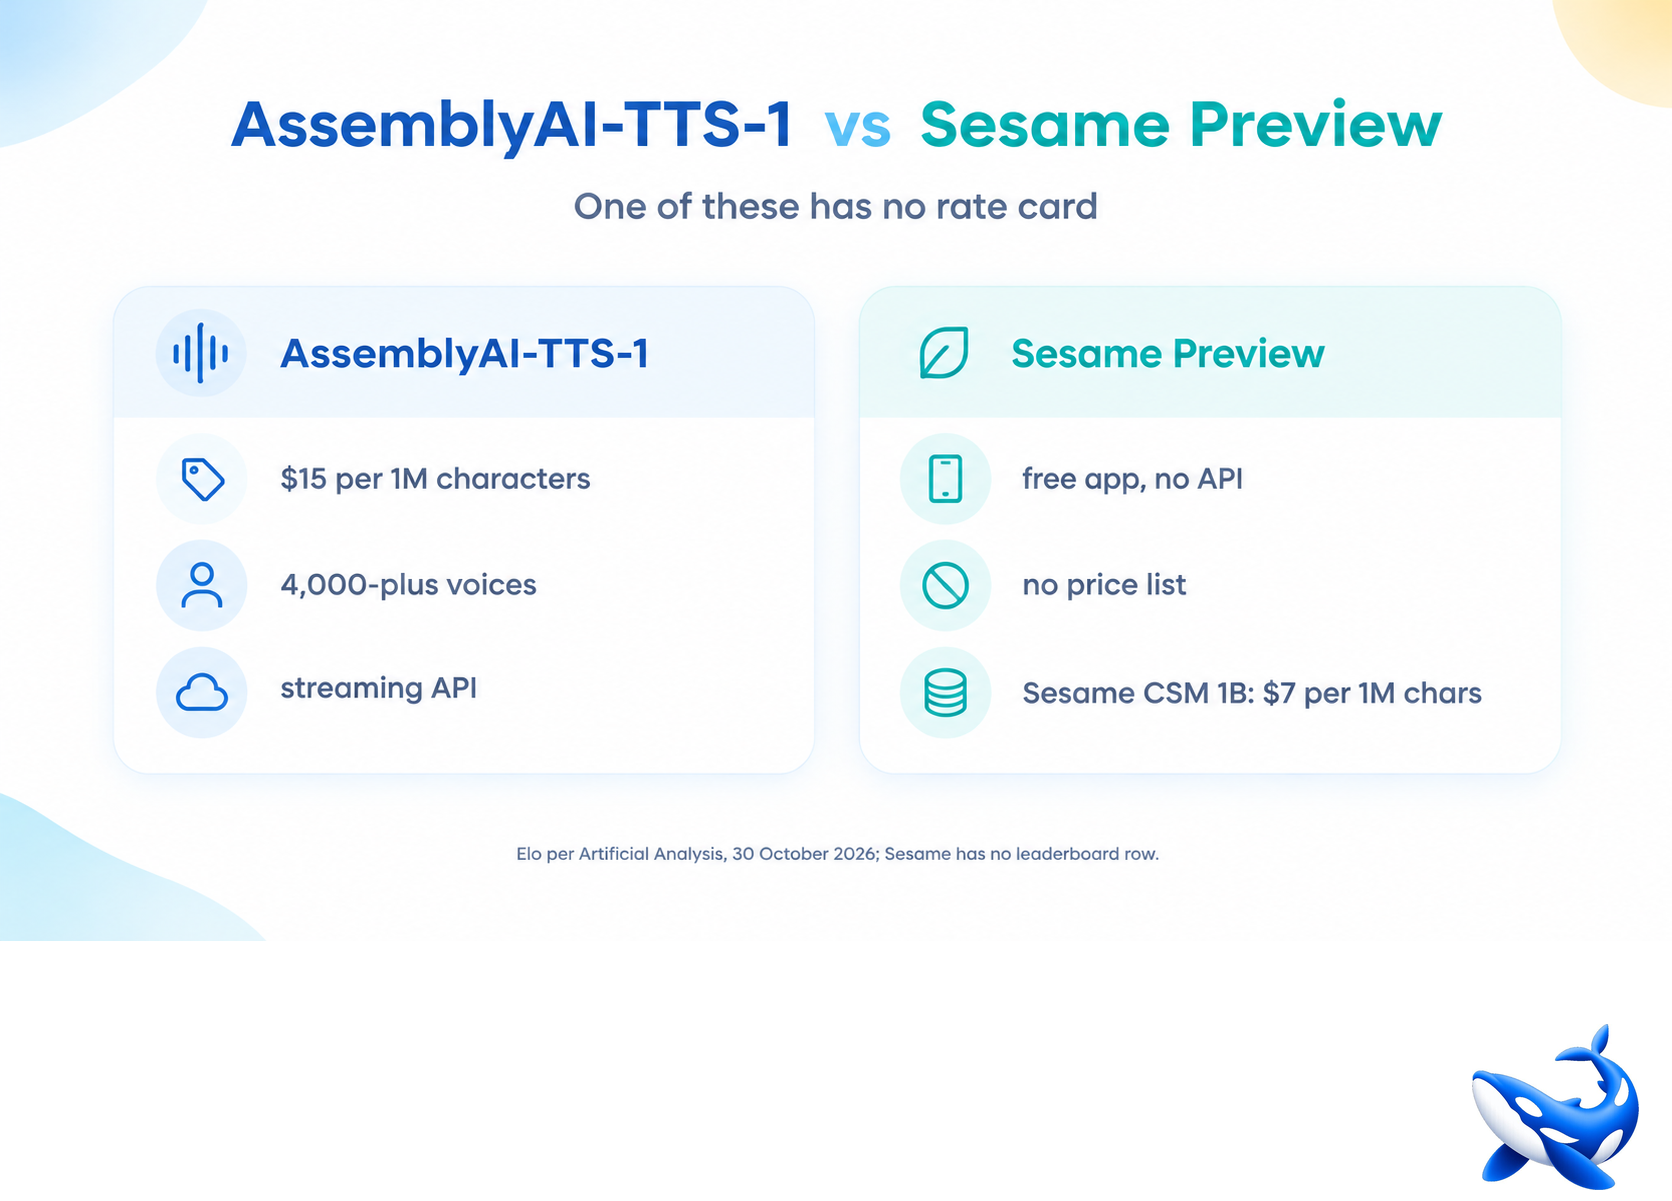
Rime Prism và AssemblyAI-TTS-1 cho thấy dịch vụ có thể tích hợp khác hẳn bản xem trước chỉ nghe được trong ứng dụng. Rime Prism là mô hình chuyển giọng nói sang giọng nói hướng tới hội thoại và được giới thiệu như một endpoint doanh nghiệp, có thể đưa vào đường dây điện thoại. AssemblyAI-TTS-1 có truyền phát qua HTTP và WebSocket ở các khu vực được nêu trong tài liệu. Cả hai cung cấp đường triển khai rõ hơn Sesame Preview, nơi nhà phát triển không có endpoint, mã mô hình hay bảng giá công khai.
Với sản phẩm thoại qua điện thoại, hãy thử nghiệm luồng trọn vẹn: thời gian phản hồi, khả năng ngắt lời, chất lượng khi đường truyền kém và hành vi khi chuyển lượt. Rime Prism được mô tả là chỉ hỗ trợ tiếng Anh khi ra mắt; Sesame Preview cũng vậy. Chất giọng nổi bật có thể giúp bản demo thuyết phục, nhưng nếu không thể gọi mô hình qua API thì nó chưa phải lựa chọn triển khai cho một nhóm phát triển.
AssemblyAI-TTS-1 là dịch vụ có thể mua và tích hợp; Sesame Preview hiện phù hợp hơn để trải nghiệm ứng dụng. Nếu muốn tự lưu trữ giọng Sesame, hãy đánh giá CSM 1B riêng: đó là checkpoint cần tự xây lớp phục vụ, không phải cách mở khóa mô hình đứng sau ứng dụng.
Chọn theo tình huống, rồi kiểm chứng số liệu
- Mua Grok Voice Transcribe 2.0 nếu cần chép lời truyền phát, kết quả từng phần và tích hợp API; bỏ qua nếu yêu cầu chính là tự lưu trữ trọng số.
- Chọn Nemotron 3.5 Transcribe nếu xử lý tệp hoàn chỉnh, cần trọng số mở hoặc độ phủ 40 ngôn ngữ; bỏ qua nếu ứng dụng cần phản hồi từng đoạn ngay khi người dùng nói.
- Chọn LFM3-Audio-2B nếu muốn tải checkpoint, chạy ngoại tuyến hoặc tự kiểm soát ngăn xếp; bỏ qua nếu nhóm không thể đáp ứng yêu cầu phần cứng, kỹ thuật và giấy phép.
- Dùng Sesame Preview để đánh giá trải nghiệm chất giọng, không xem đó là API sản xuất; nếu cần tự sở hữu lớp phục vụ, hãy xem xét CSM 1B như một mô hình riêng.
- Cân nhắc Rime Prism hoặc AssemblyAI-TTS-1 khi cần dịch vụ tích hợp cho thoại; bỏ qua Sesame Preview cho quy trình cần endpoint, mã mô hình và điều khoản thương mại rõ ràng.
Điểm benchmark và số liệu hiệu năng trong tài liệu không phải lúc nào cũng được kiểm chứng độc lập. AA-WER có thể dao động gần một điểm giữa các endpoint phục vụ của cùng mô hình, khiến chênh lệch nửa điểm trở nên yếu để kết luận. Một số bảng xếp hạng còn thiếu tái tạo từ bên thứ ba, và các mô hình đang xét chưa có mặt trong chỉ số độc lập về chuyển giọng nói thành giọng nói được nhắc tới. Hãy thử trên dữ liệu, thiết bị và điều kiện mạng của chính sản phẩm trước khi cam kết.
Kết luận: hãy bắt đầu từ đường triển khai và yêu cầu độ trễ. Mô hình có giọng hay nhất không giúp được nếu không có API; checkpoint mở cũng không miễn phí về vận hành chỉ vì tải xuống được. Chọn công cụ khớp với kiến trúc, giấy phép và đội ngũ của bạn, rồi mới so sánh chất lượng bằng thử nghiệm thực tế.