
Mô hình nhỏ, tuyên bố lớn
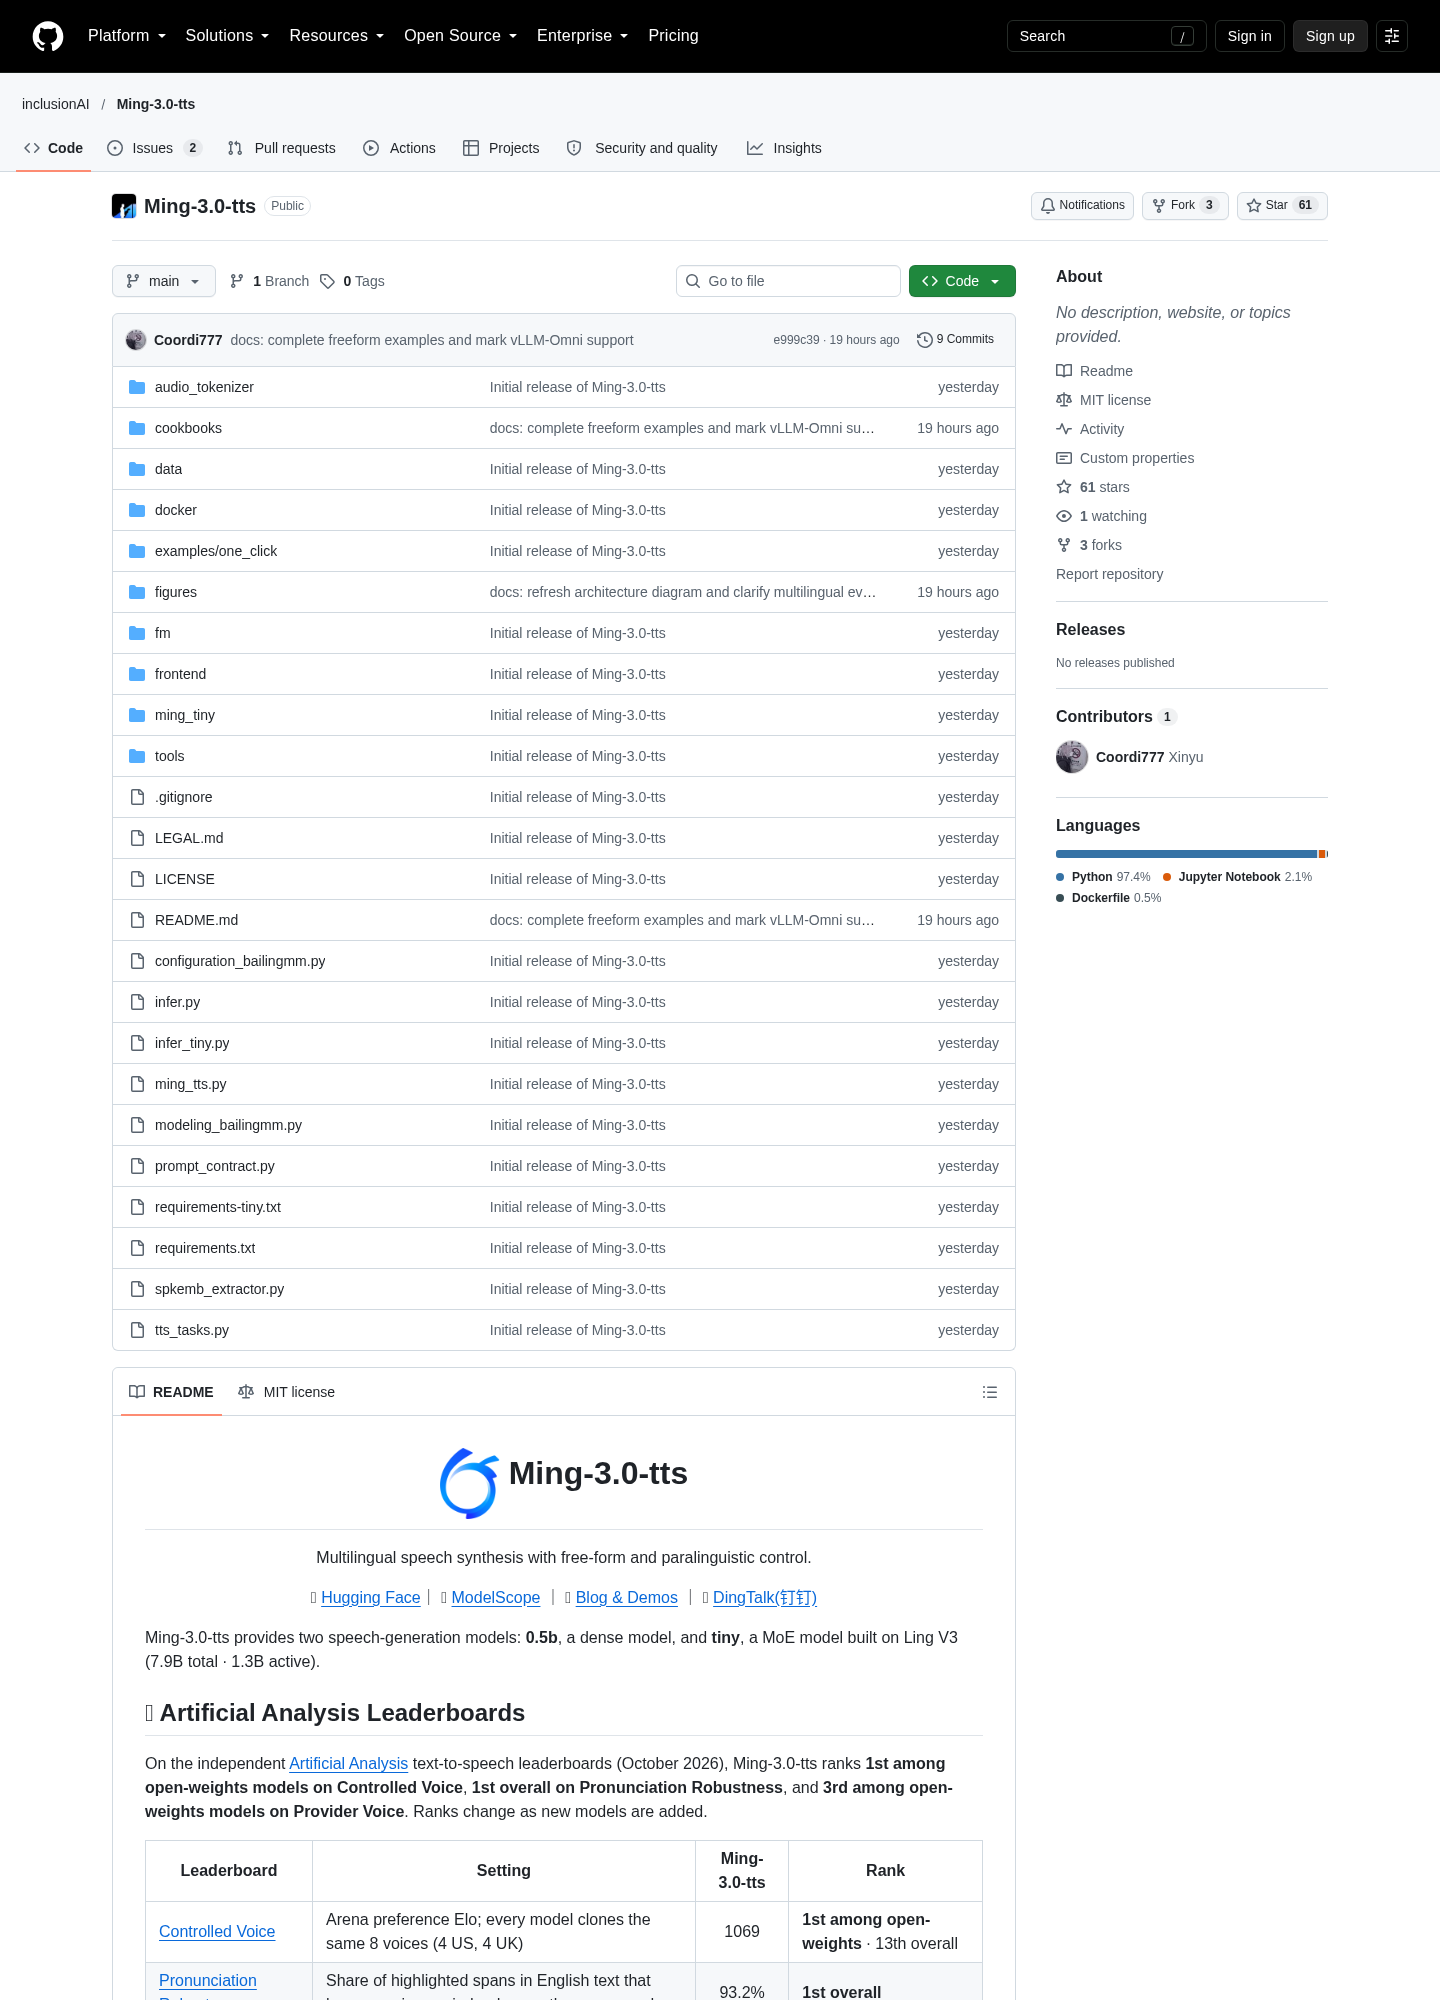
Ming-3.0-TTS là dòng mô hình chuyển văn bản thành giọng nói của Ant Group, gồm các checkpoint tạo giọng nói AI với trọng số có thể tải về và chạy trên hạ tầng riêng. Bản 0,5 tỷ tham số được phát hành công khai ngày 20 tháng 10 năm 2026 theo giấy phép MIT; trọng số có trên các kho phân phối mô hình, còn mã suy luận được đưa lên kho GitHub riêng. Đáng chú ý, checkpoint đã xuất hiện trên Hugging Face từ tháng 9, trước khi mã chạy và thông báo phát hành rộng rãi được công bố. Vì vậy, điều mới không hẳn là trọng số, mà là khả năng vận hành chúng mà không phải tự lần ngược cách sử dụng checkpoint. Bản dense dùng backbone Qwen2.5-0.5B và có dung lượng khoảng 2,96 GB. Đây là quy mô đủ nhỏ để khiến lựa chọn giữa thuê dịch vụ và tự chạy trở thành bài toán thực tế, thay vì cuộc đua chỉ dành cho các trung tâm dữ liệu.
Tuyên bố nổi bật là điểm phát âm tiếng Anh 93,2%, đồng hạng nhất trên bảng đánh giá được dẫn trong tài liệu phát hành. Con số này đáng chú ý với một mô hình 0,5B, nhưng không nên bị hiểu thành bảo đảm chất lượng cho mọi giọng đọc. Bảng xếp hạng thưởng cho độ chính xác ở cấp chuỗi; các tên riêng, thuật ngữ hiếm và cách viết bất thường trong ứng dụng thật có thể làm lộ điểm yếu. Nói cách khác, điểm benchmark là lý do để thử mô hình, không phải lý do để bỏ qua kiểm thử. Nếu sản phẩm cần đọc đúng những từ như “Kubernetes”, tên người hoặc họ khách hàng, hãy đánh giá bằng chính dữ liệu đó trước khi triển khai.
Hai checkpoint, hai thế mạnh khác nhau
Không nên gom hai checkpoint TTS dưới cùng một nhãn “nhỏ”. Ming-3.0-tts-0.5B là mô hình dense khoảng 0,5 tỷ tham số, trong khi Ming-3.0-tts-tiny là mô hình mixture-of-experts có tổng cộng 7,9 tỷ tham số và kích hoạt khoảng 1,3 tỷ tham số mỗi token. Tên “tiny” vì thế nói nhiều hơn về lượng tham số hoạt động trong quá trình xử lý, chứ không phản ánh kích thước tải xuống: checkpoint này chiếm khoảng 18 GB. Nó còn bổ sung khả năng tạo podcast nhiều người nói, nên không phải đơn thuần là bản lớn hơn của cùng một sản phẩm.
Trong đánh giá tiếng Trung trên Seed-TTS, bản tiny đạt điểm tương đồng người nói 0,781, mức cao nhất trong các bảng của Ant được nêu trong nguồn. Đây là kết quả có ý nghĩa nếu nhu cầu chính là giữ đặc trưng giọng tham chiếu, nhưng cũng cần phân biệt khả năng nhân bản giọng với chất lượng giọng dựng sẵn: tài liệu mô tả bản 0,5B mạnh hơn khi nhân bản giọng so với khi dùng giọng có sẵn của chính nó. Dòng sản phẩm hỗ trợ nhân bản zero-shot từ đoạn âm thanh tham chiếu ngắn, tạo giọng theo mô tả ngôn ngữ tự nhiên và điều khiển phong cách. Những tính năng ấy làm tăng độ linh hoạt, song người dùng vẫn cần kiểm tra quyền sử dụng giọng và chất lượng đầu ra trong bối cảnh cụ thể.
Điểm tiếng Hàn cần được đọc thận trọng
Kết quả tiếng Hàn là lời nhắc rõ nhất rằng một bảng điểm đẹp không đồng nghĩa mô hình giỏi đồng đều. Bản Ming-3.0-tts-tiny được ghi nhận có tỷ lệ lỗi ký tự 6.000%, đứng thứ sáu trong tám hệ thống; bản 0,5B đạt 1,728% trên cùng ngôn ngữ. Nguồn cho biết hai số liệu được tạo bằng cùng khung đánh giá, cùng nhóm thực hiện và trong cùng ngày, nhưng không giải thích nguyên nhân chênh lệch. Cũng cần xác minh cách ghi “6.000%”: dấu chấm ở đây biểu thị phần thập phân theo quy ước nào, và chỉ số lỗi ký tự được tính trên tập dữ liệu, cách chuẩn hóa văn bản ra sao? Không có các chi tiết ấy, không nên đọc con số như một dự báo chính xác cho mọi ứng dụng tiếng Hàn.
Bảng đa ngôn ngữ được mô tả so sánh mô hình nhỏ với bảy hệ thống khác trên sáu ngôn ngữ. Mô hình có kết quả dẫn đầu ở một số ngôn ngữ, đồng hạng nhì ở tiếng Nhật và đứng thứ hai ở tiếng Pháp, nhưng chính bảng cũng ghi nhận giới hạn về tương đồng người nói ở tiếng Pháp. Vì thế, thứ hạng nên được xem là một lát cắt của năng lực, không phải chứng nhận chất lượng tổng quát. Với sản phẩm có người dùng tiếng Hàn, quyết định hợp lý là chạy thử trên nội dung thực tế, đánh giá cả phát âm, độ tự nhiên lẫn mức ổn định, rồi mới chọn checkpoint.
Tự lưu trữ không đồng nghĩa miễn phí
Giấy phép MIT cho cả hai checkpoint là điểm cộng thực dụng: nguồn mô tả không có cổng chặn, bước chấp nhận chính sách sử dụng hợp lý hay ngoại lệ về sử dụng thương mại. Nhưng quyền dùng rộng không xóa đi chi phí vận hành. Bản 0,5B có thể nằm trên một GPU tiêu dùng 24 GB ở BF16, còn môi trường được Ant khuyến nghị dùng H800. Nếu doanh nghiệp đã có GPU nhàn rỗi, tự lưu trữ có thể giảm chi phí biên khi lượng tạo giọng tăng. Nếu chưa có hạ tầng, khoản đầu tư phần cứng, thời gian cấu hình và công sức xử lý phụ thuộc có thể khiến dịch vụ API hợp lý hơn trong giai đoạn đầu.
Mã nguồn hiện được mô tả ở mức nghiên cứu, kho Hugging Face chủ yếu phân phối checkpoint và muốn suy luận phải lấy mã từ kho GitHub riêng. Chưa có báo cáo kỹ thuật, còn hỗ trợ vLLM-Omni mới nằm trong lộ trình và chưa được kiểm chứng; vì vậy chưa thể mặc định rằng mô hình đã sẵn sàng cho phục vụ thông lượng cao. Kết luận: Ming-3.0-TTS đáng thử nhờ quy mô 0,5B, giấy phép MIT và kết quả phát âm nổi bật, nhưng lợi thế chỉ thành giá trị khi chất lượng được kiểm tra bằng dữ liệu thật và chi phí GPU phù hợp với hạ tầng của bạn.