
Từ kiểm tra từng hồ sơ đến nhìn thấy toàn cảnh
Kiểm toán dữ liệu lớn là cách khai thác, đối chiếu khối lượng thông tin số từ nhiều hệ thống để giúp kiểm toán viên phát hiện bất thường, xác định trọng tâm và đánh giá rủi ro trên phạm vi rộng hơn. Đây là bước chuyển cần thiết khi hoạt động quản lý công ngày càng để lại dấu vết trên các nền tảng số.
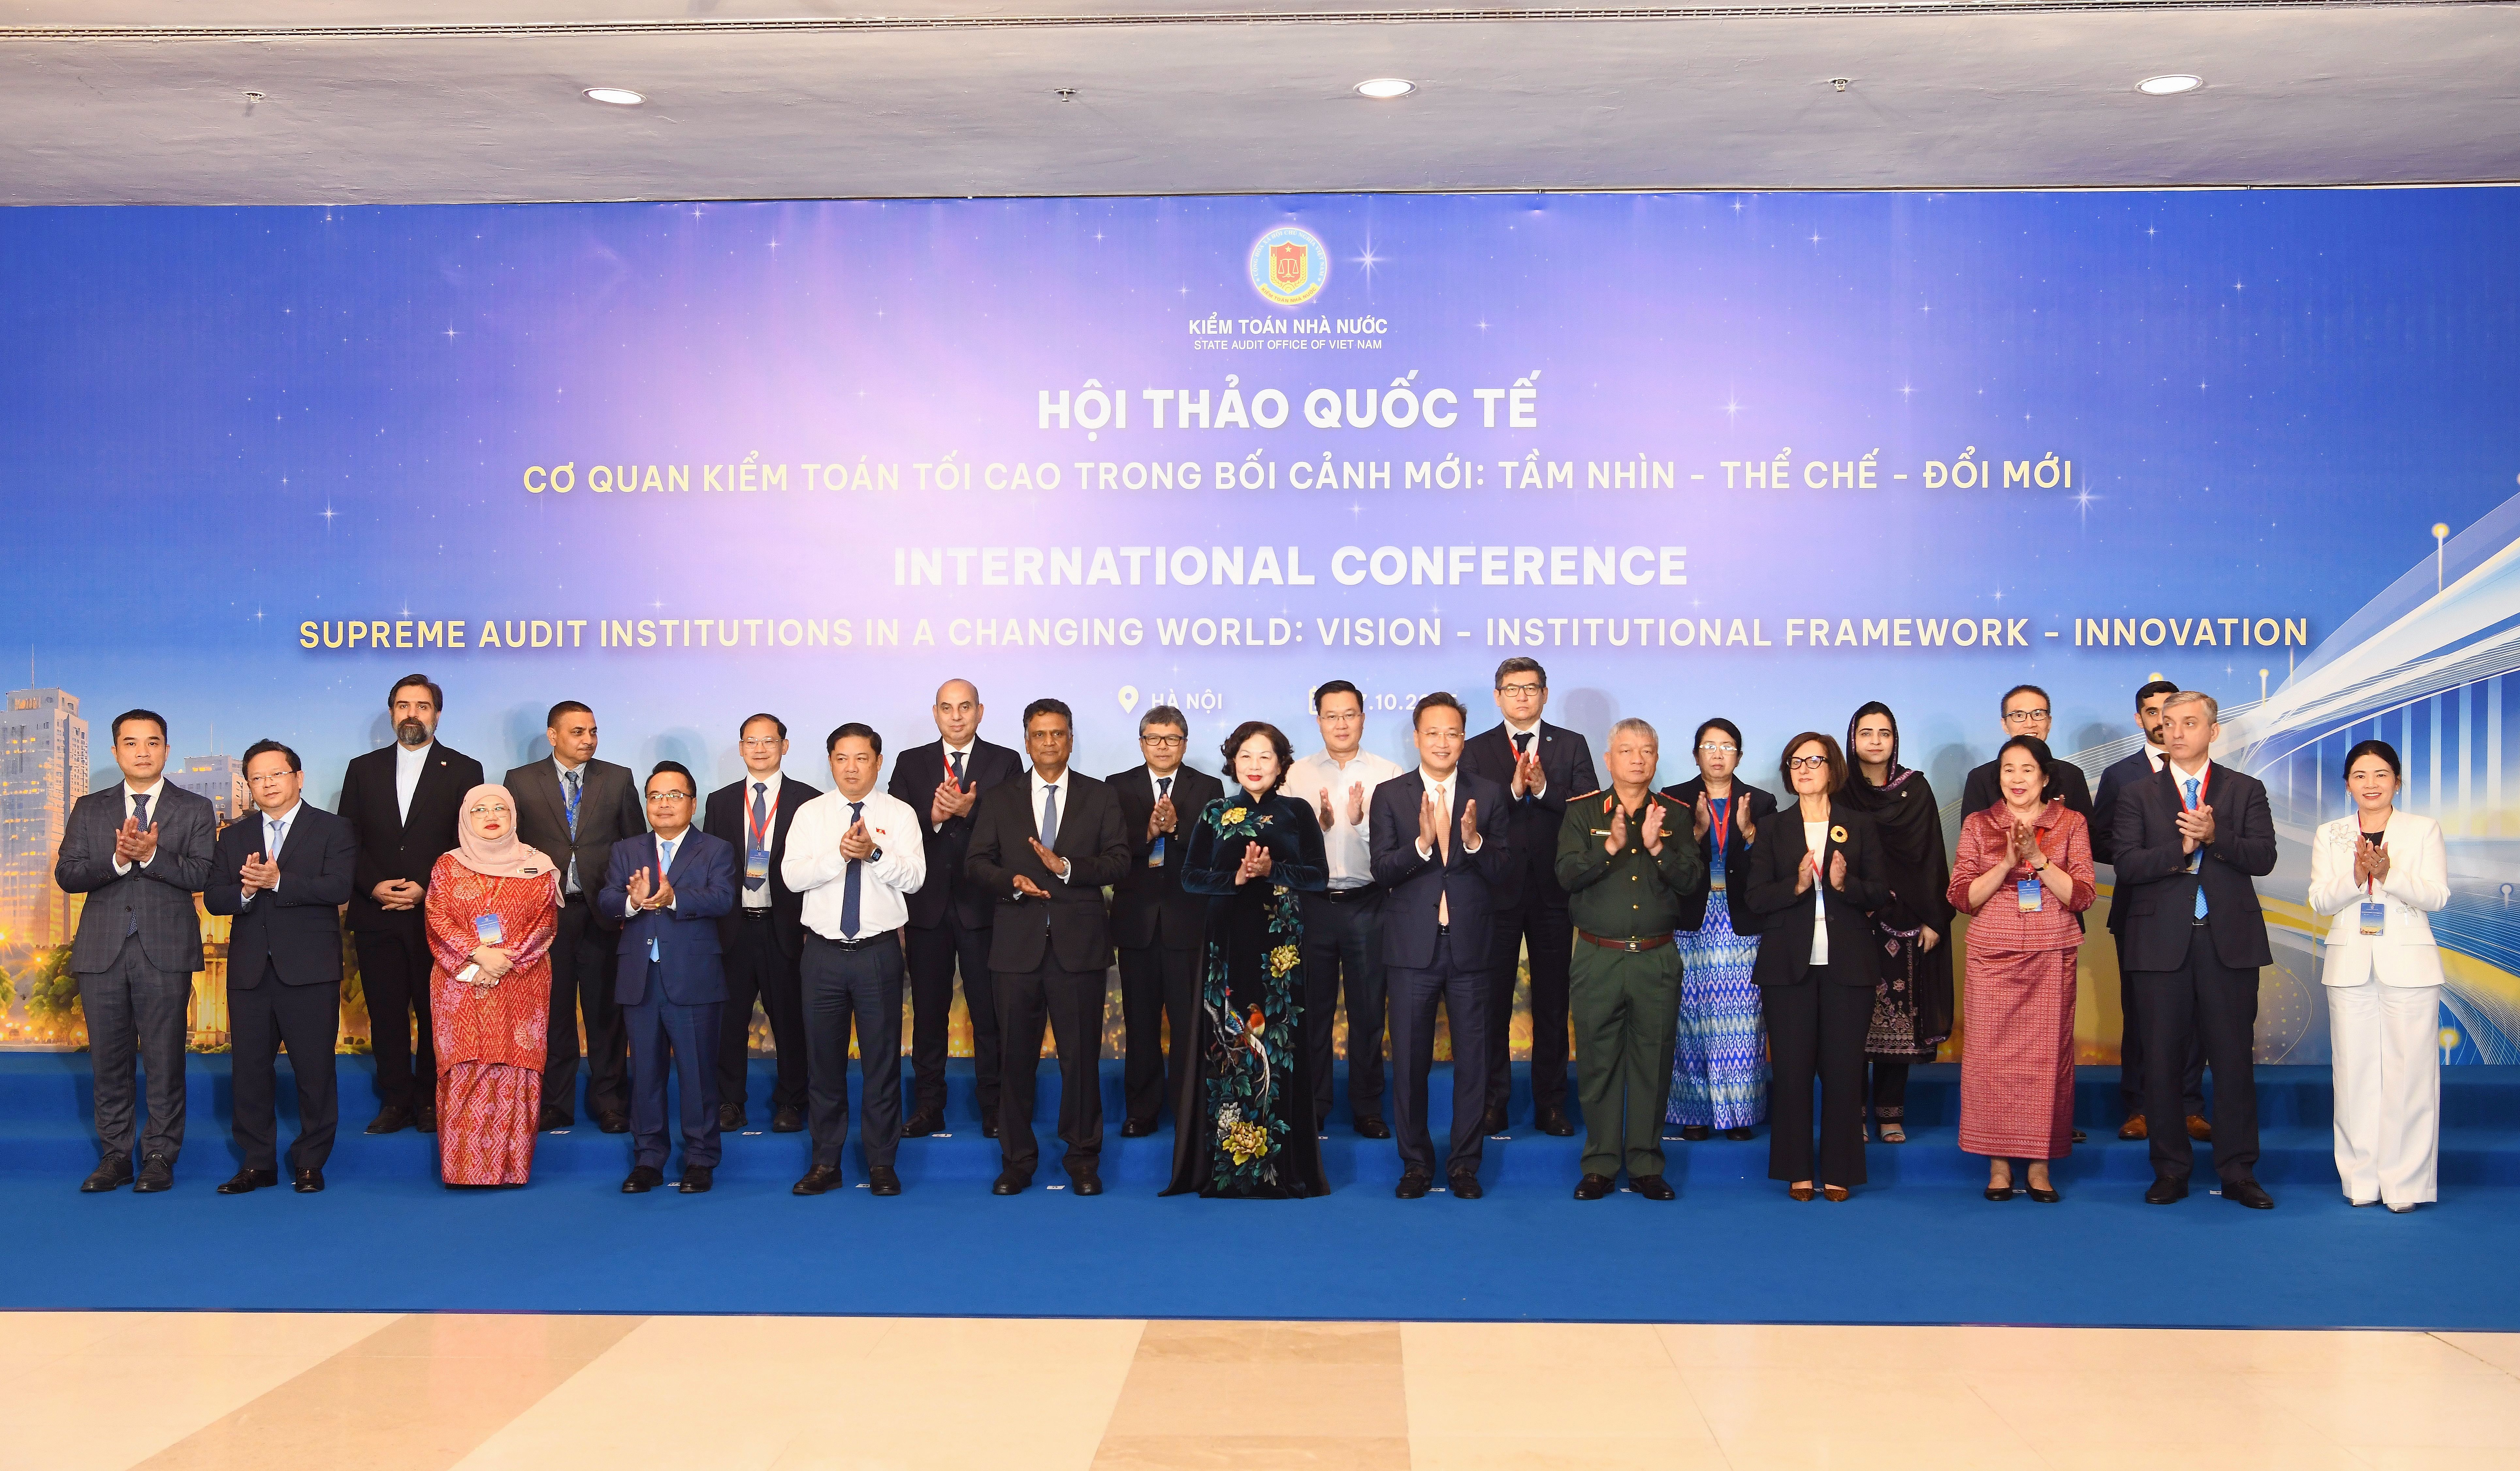
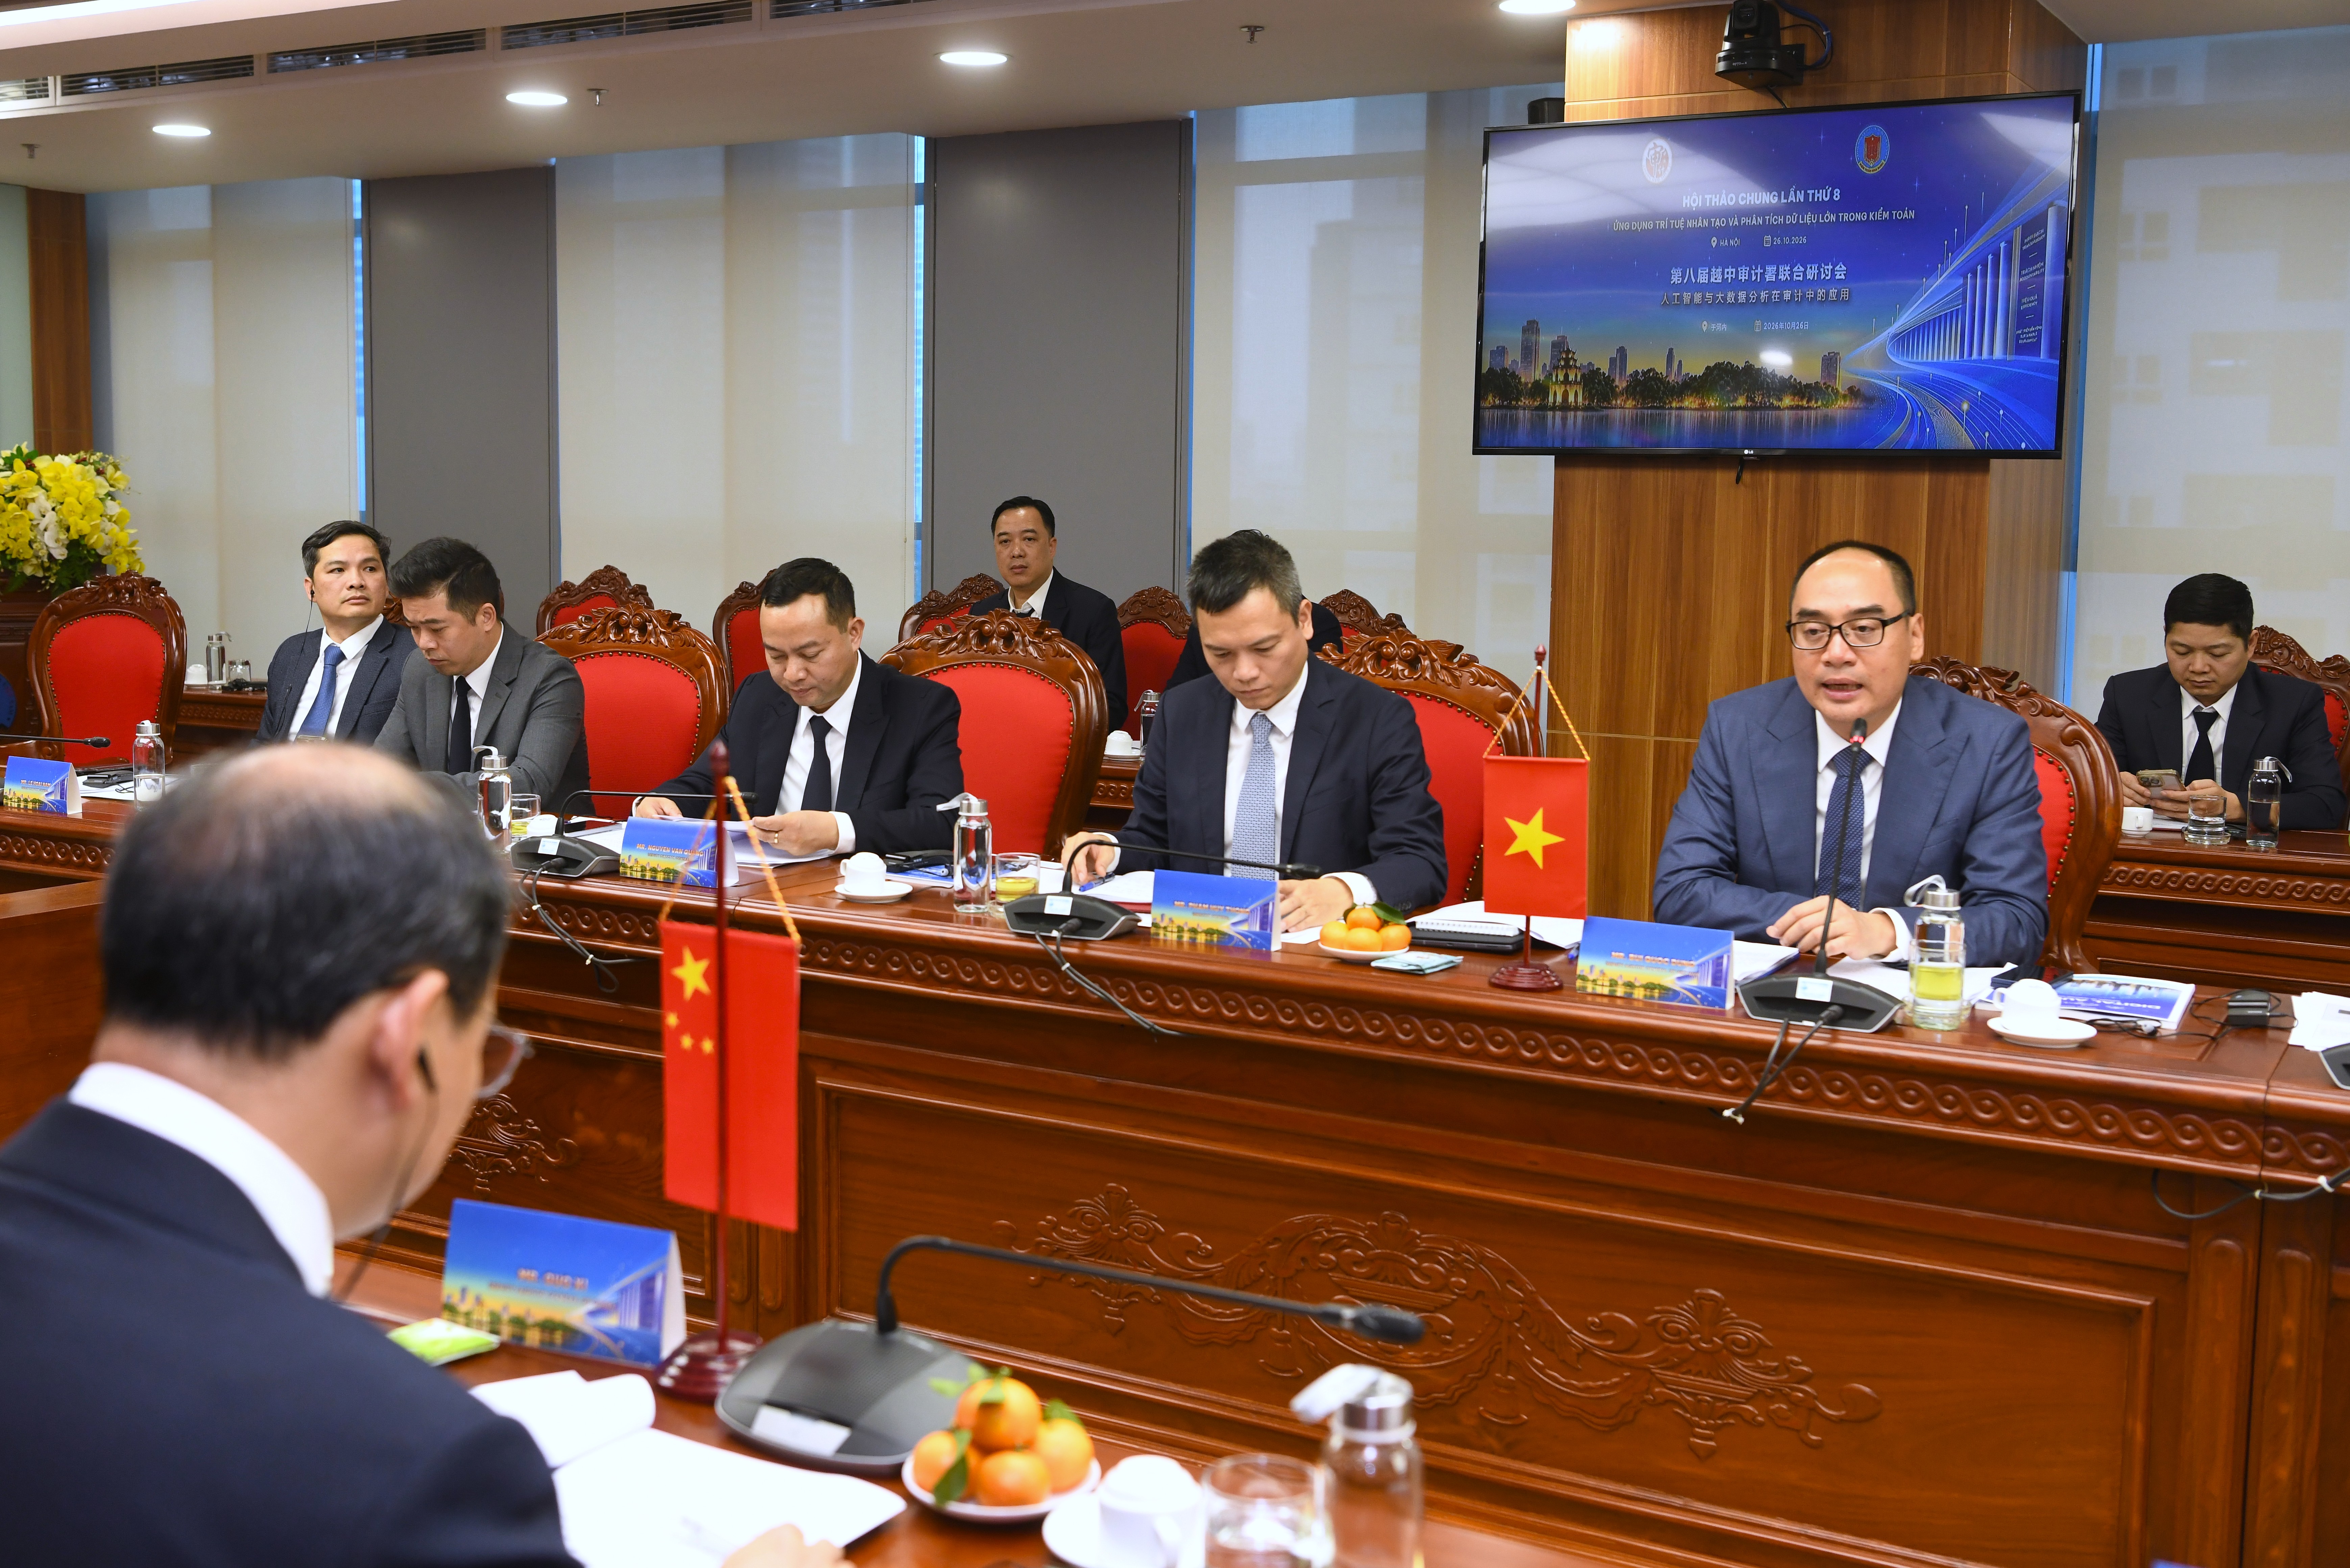
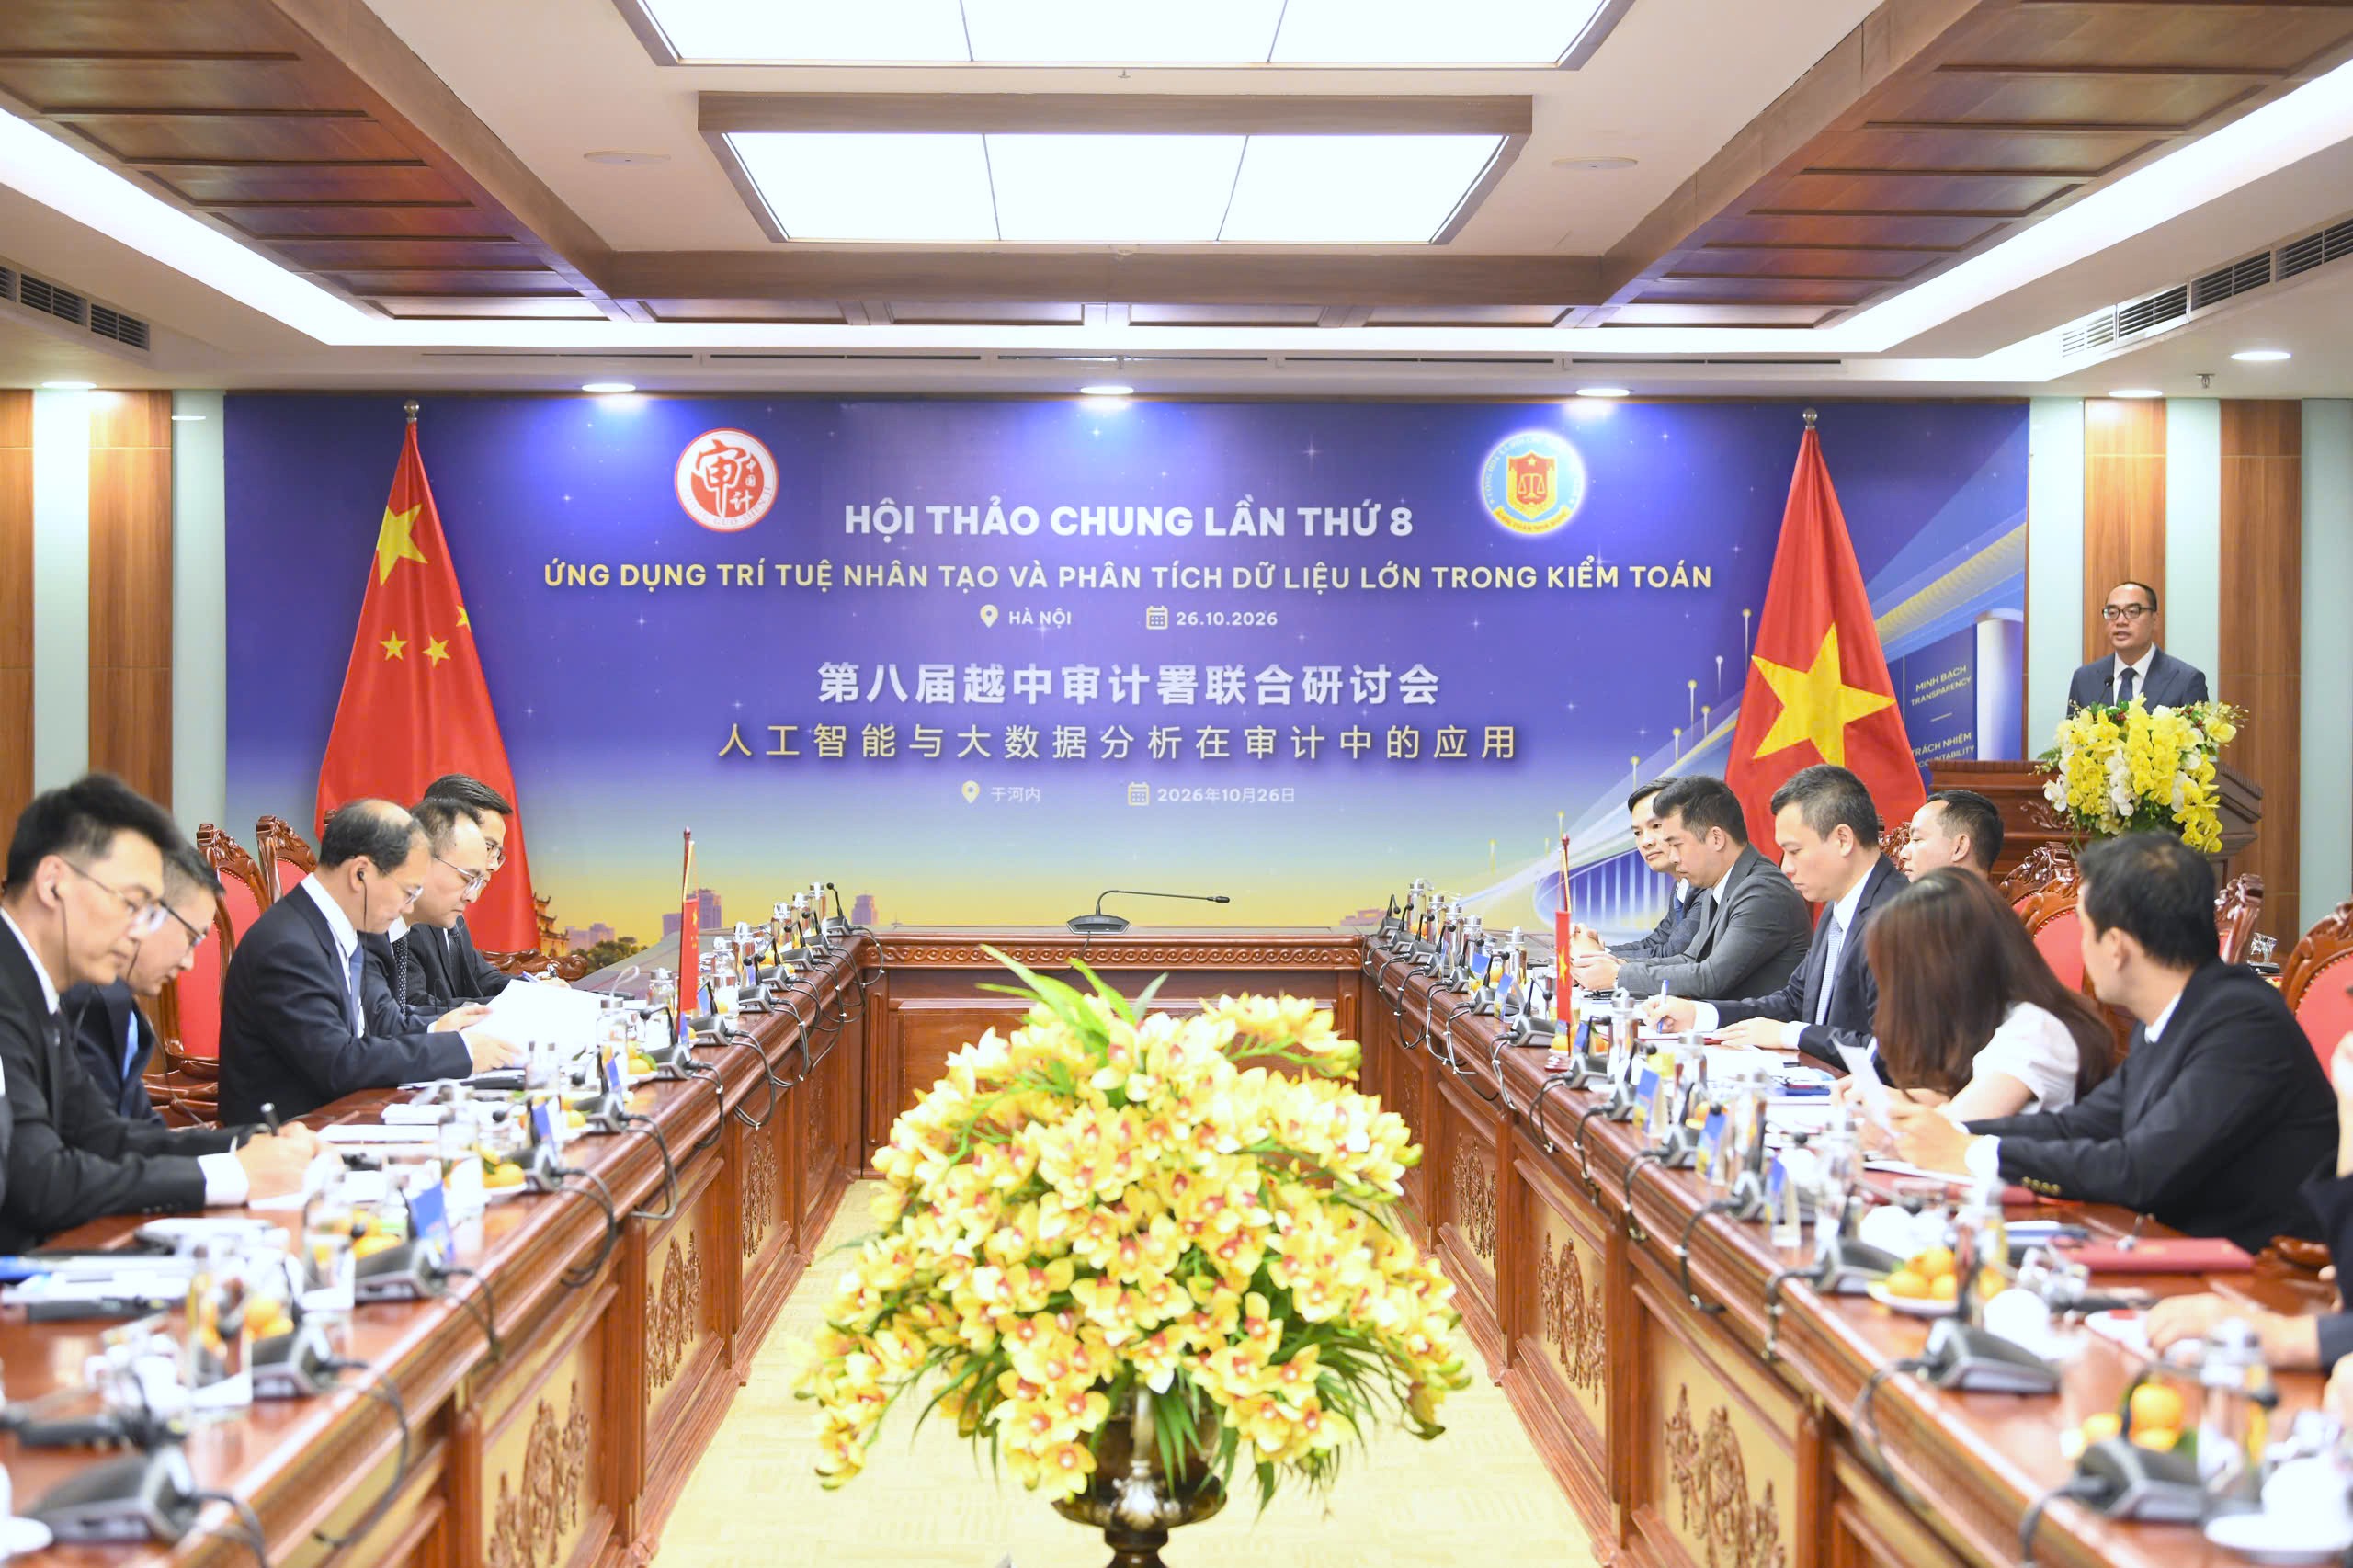
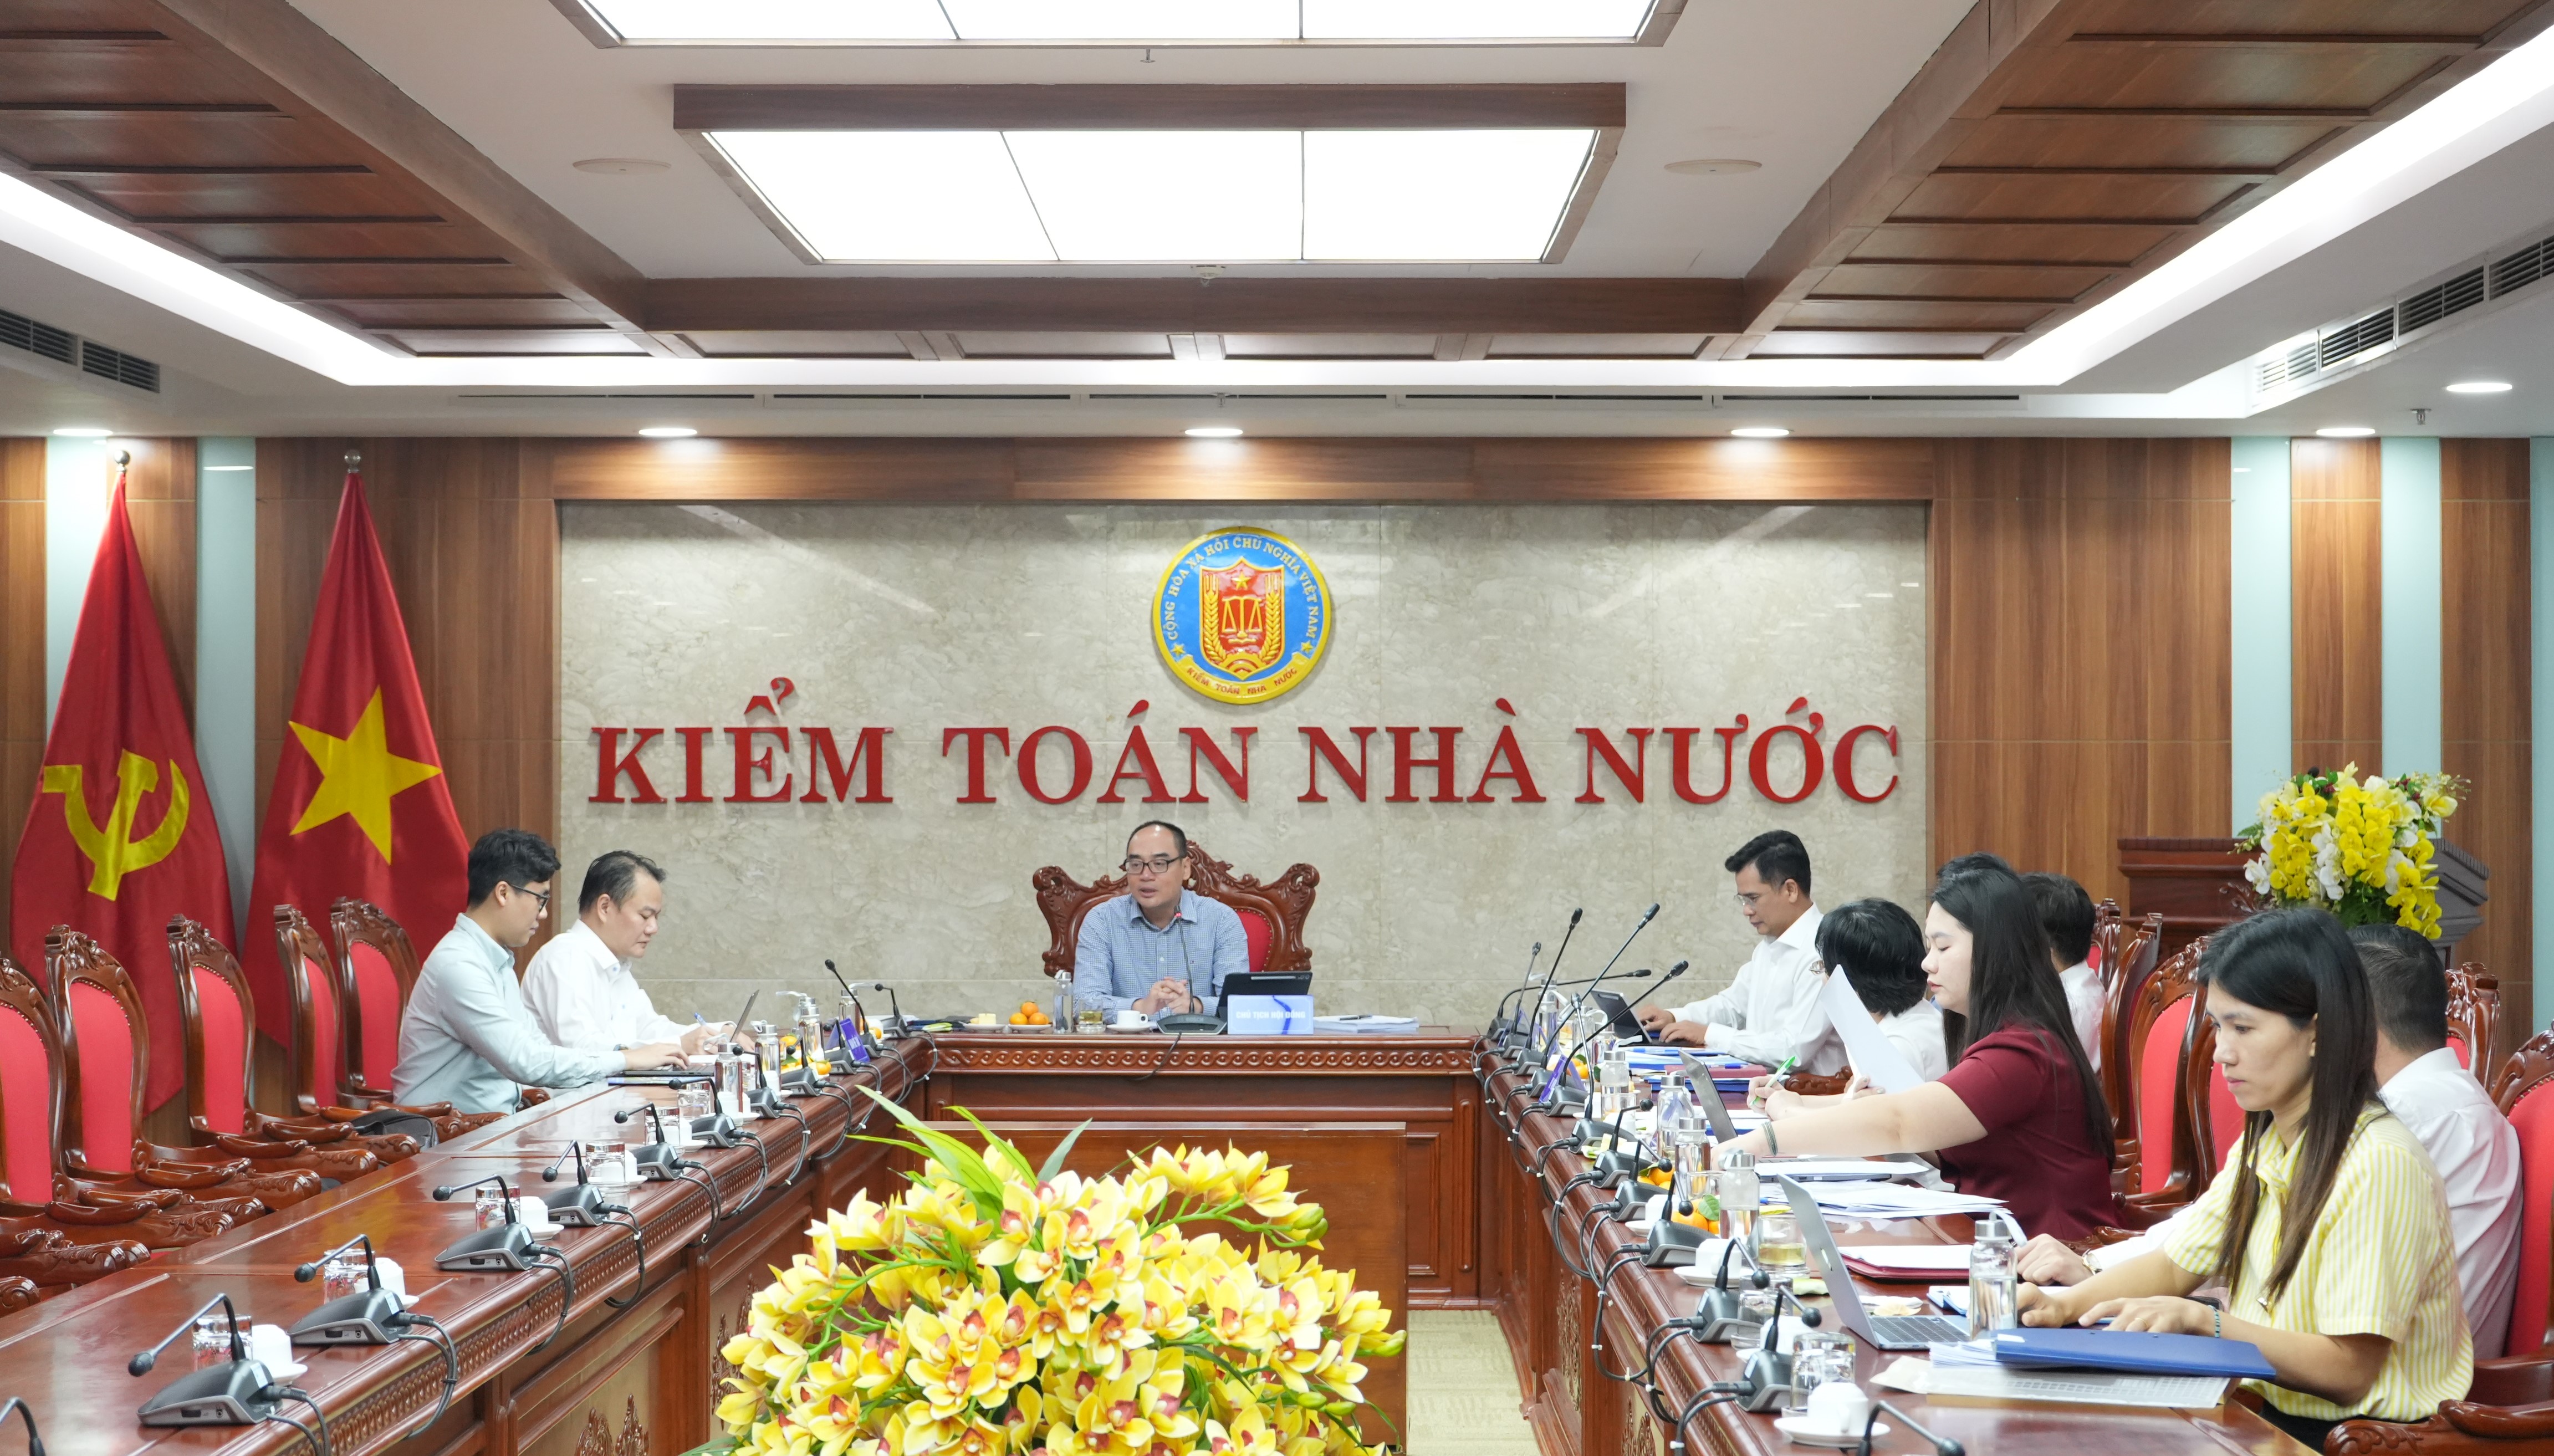
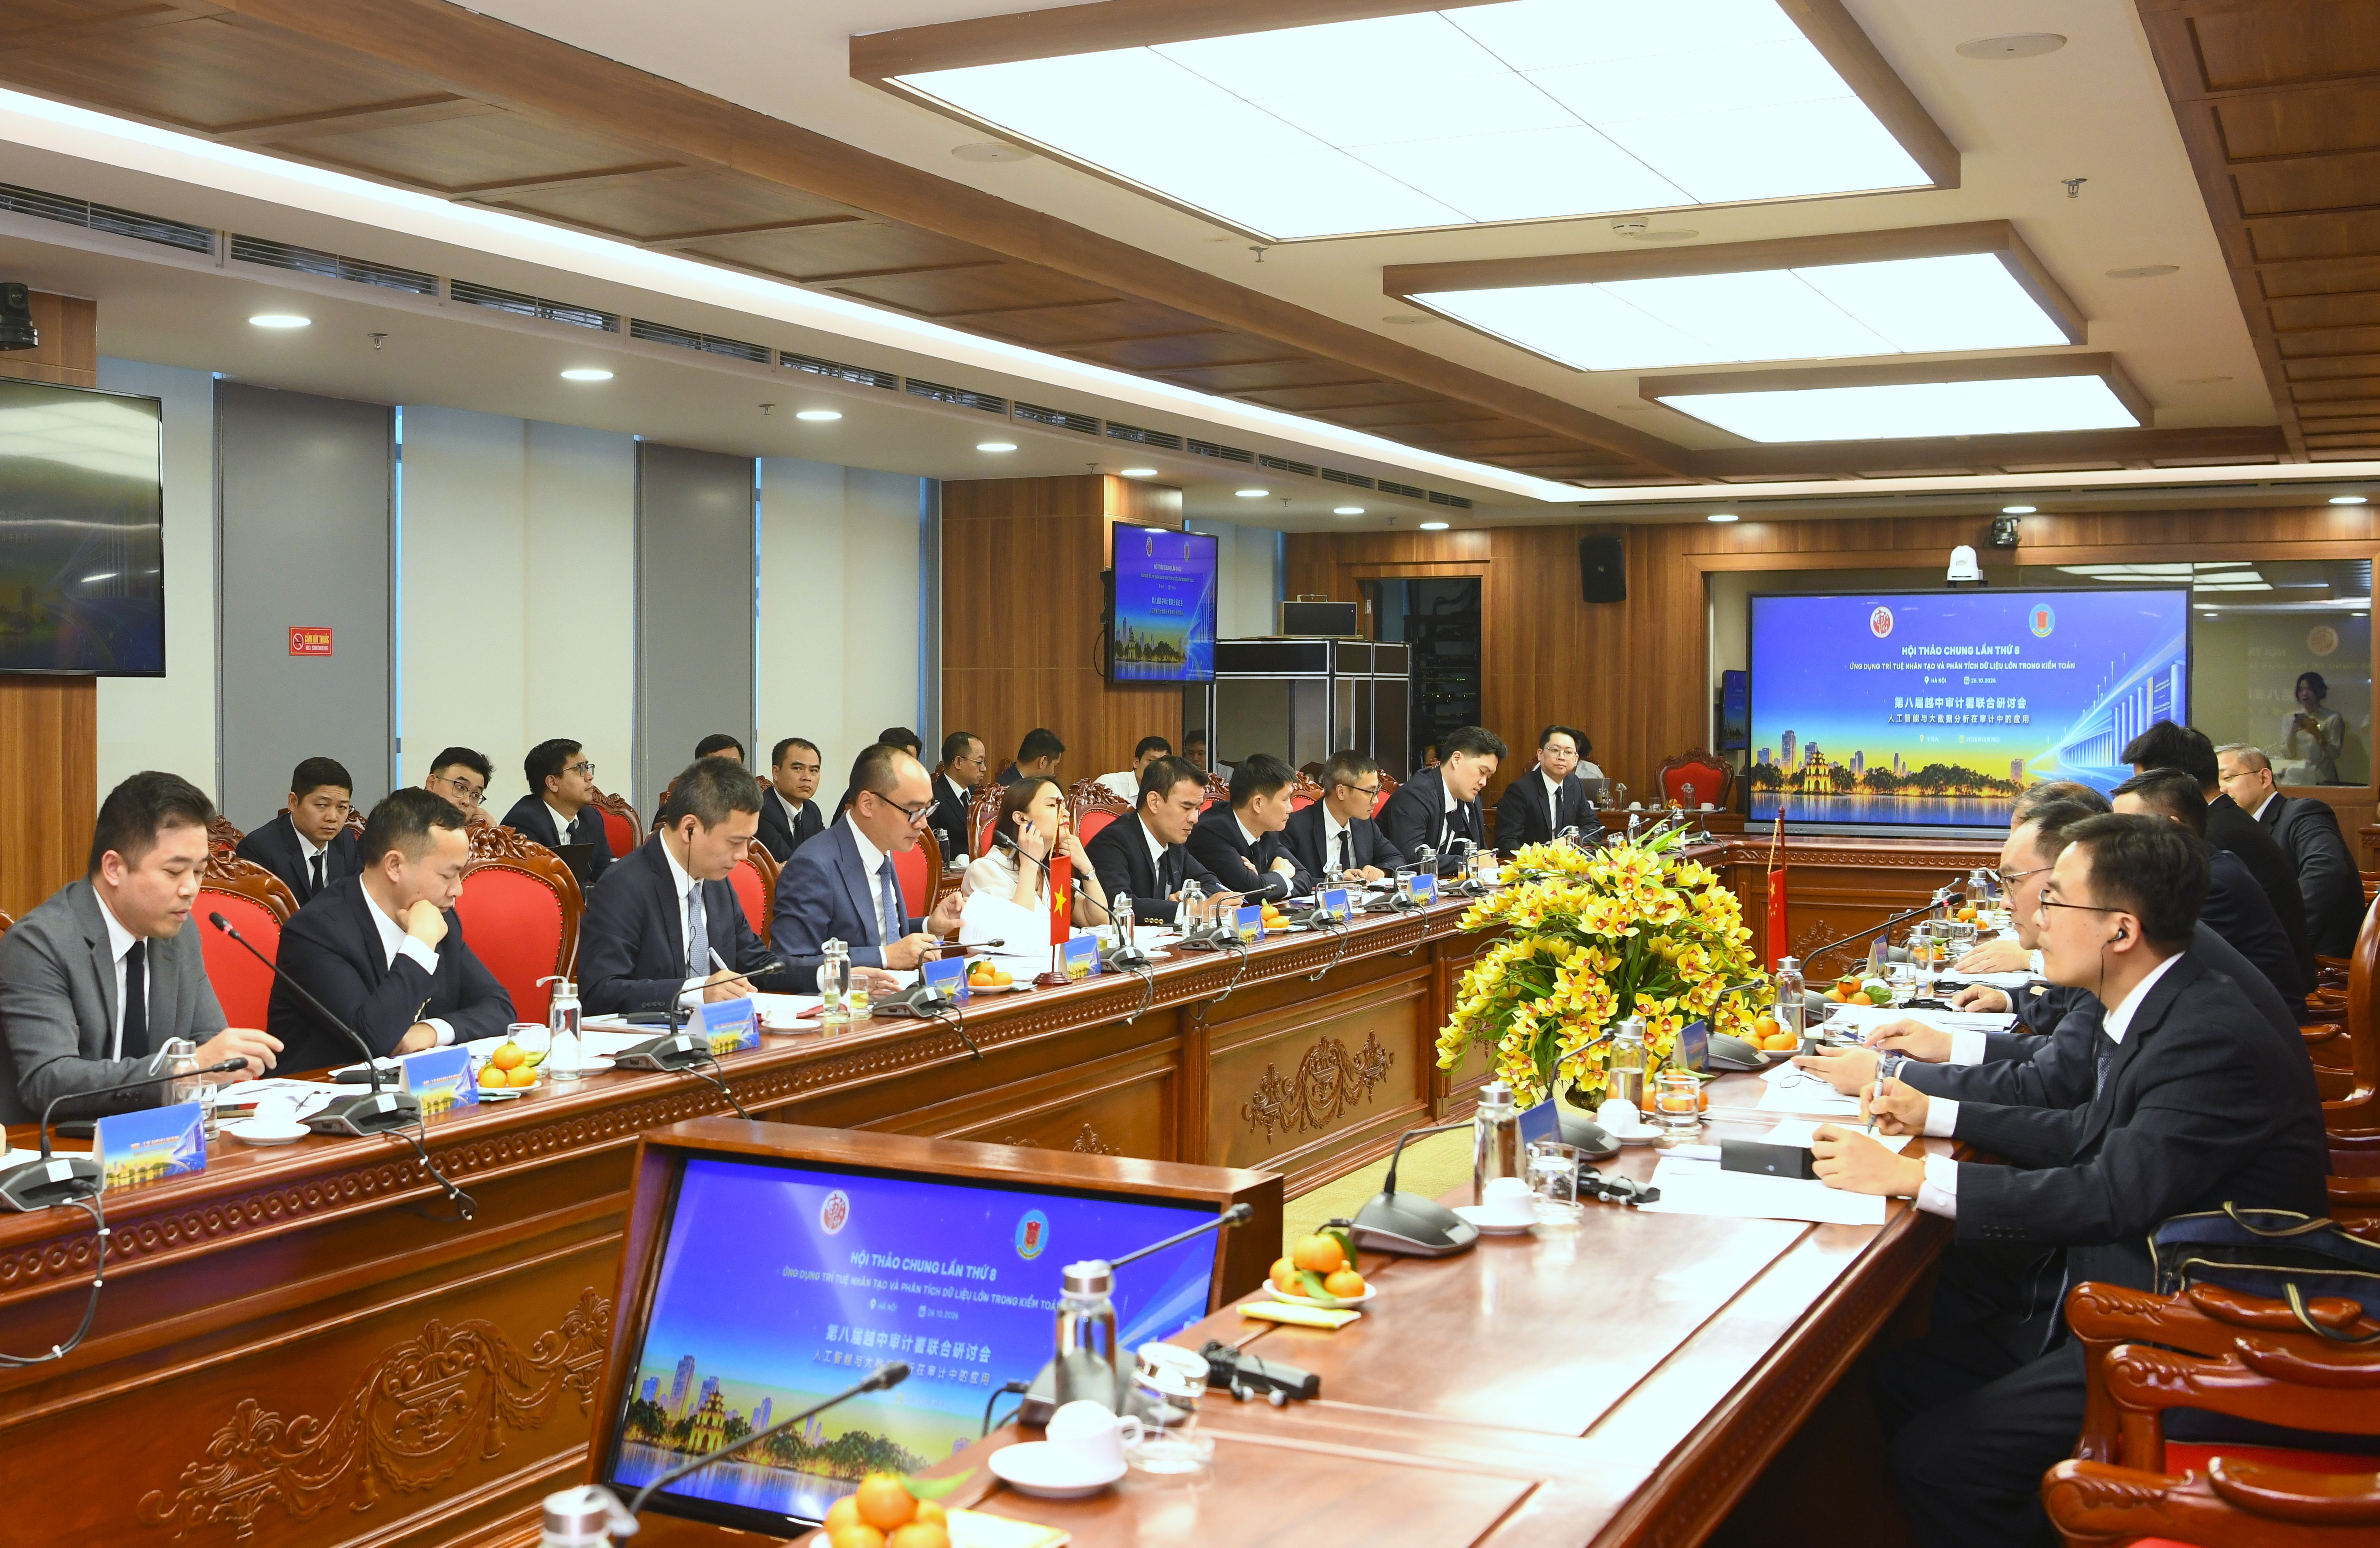
Ngày 26/10 tại Hà Nội, Kiểm toán nhà nước Việt Nam và Cơ quan Kiểm toán quốc gia Trung Quốc tổ chức hội thảo chung lần thứ 8, trao đổi về chuyển đổi số, dữ liệu lớn và AI trong kiểm toán. Điểm đáng chú ý không nằm ở việc có thêm công cụ, mà ở khả năng nối những dữ liệu trước đây bị chia cắt: kho bạc, thuế, đất đai, bảo hiểm xã hội và các hệ thống hành chính. Kho dữ liệu kiểm toán của Việt Nam đã có hơn 100 triệu bản ghi; hệ thống của Trung Quốc tích hợp 16 lĩnh vực, khoảng 29.400 cơ sở dữ liệu và 8,18 nghìn tỷ bản ghi. Quy mô đó mở ra cơ hội đối chiếu giao dịch và mối liên hệ mà kiểm tra từng hồ sơ riêng lẻ khó nhận ra.
AI trong kiểm toán có thể sàng lọc thông tin, nhận diện dấu hiệu bất thường và hỗ trợ chọn nội dung cần xem xét. Phía Trung Quốc cho biết AI đã được ứng dụng ở nhiều khâu; phía Việt Nam đang thí điểm công nghệ trong lựa chọn đối tượng kiểm toán, kiểm soát chất lượng và phân tích dữ liệu. Lợi ích thực tế là kiểm toán viên có thể dành ít thời gian hơn cho thao tác rà soát lặp lại, còn người dân được hưởng lợi gián tiếp từ việc xử lý thông tin nhanh hơn và giảm hồ sơ giấy, chi phí đi lại.

Chuẩn hóa dữ liệu là điều kiện, không phải việc phụ
Dữ liệu nhiều không đồng nghĩa với phân tích tốt. Nếu mỗi hệ thống dùng định dạng khác nhau, thiếu cập nhật hoặc không rõ nguồn gốc, thuật toán có thể phát hiện tương quan sai và khiến kiểm toán viên theo đuổi những dấu hiệu không có ý nghĩa. Vì thế, chuẩn hóa dữ liệu và kết nối liên ngành phải đi trước tham vọng tự động hóa.
Kinh nghiệm được chia sẻ tại hội thảo nhấn mạnh kho dữ liệu không chỉ là nơi tập hợp và lưu trữ thông tin: cần cơ chế cập nhật thường xuyên, thống nhất định dạng và đánh giá giá trị sử dụng. Kết nối dữ liệu từ trung ương đến địa phương giúp đối chiếu thông tin, nhận diện quan hệ giữa các lĩnh vực và nâng hiệu quả phân tích. Nói cách khác, chất lượng đầu vào quyết định giới hạn của mọi kết quả đầu ra.
Đây cũng là lý do triển khai AI trong kiểm toán không thể tách rời cơ sở pháp lý, hạ tầng, bảo mật và năng lực kiểm toán viên. Một mô hình có thể xử lý nhanh, nhưng nếu quyền truy cập không được kiểm soát, dữ liệu thiếu nhất quán hoặc quy trình không thể giải trình, tốc độ chỉ làm sai sót lan nhanh hơn. Kế hoạch tiếp theo của cơ quan kiểm toán Việt Nam là tiếp tục phát triển nền tảng dữ liệu tập trung, tăng kết nối, hoàn thiện công cụ phân tích dùng chung và ưu tiên ứng dụng AI ở những khâu có giá trị thiết thực.
Cảnh báo của thuật toán chưa phải bằng chứng
Ranh giới quan trọng nhất của phân tích dữ liệu kiểm toán là ranh giới giữa một tín hiệu cần kiểm tra và bằng chứng đủ sức nâng đỡ kết luận. Một cảnh báo có thể bắt nguồn từ lỗi dữ liệu, đặc thù nghiệp vụ hợp lý hoặc vấn đề thực sự. Nếu coi mọi cảnh báo là sai phạm, công nghệ sẽ làm tăng khối lượng kiểm tra mà không nâng độ tin cậy của kiểm toán.
Quy trình chuyển dữ liệu số thành bằng chứng cần đi qua năm chặng: tiếp nhận dữ liệu nguồn; chuẩn bị và chuyển đổi; phân tích, tạo cảnh báo; xác minh cảnh báo; rồi hình thành bằng chứng và lưu hồ sơ. Mỗi bước phải có dấu vết để truy xuất và có thể tái lập. Kiểm toán viên cần biết dữ liệu đến từ đâu, đã qua xử lý gì, tiêu chí nào tạo ra cảnh báo và kết quả xác minh dựa trên tài liệu nào.
Công nghệ hỗ trợ sàng lọc và rút ngắn thời gian xử lý, nhưng đánh giá bằng chứng, đưa ra nhận định chuyên môn và kết luận vẫn thuộc trách nhiệm của kiểm toán viên. Đây không phải giới hạn cần tìm cách né tránh, mà là cơ chế bảo đảm trách nhiệm giải trình. Một phân tích chỉ nên được sử dụng theo mức độ phù hợp với mức xác minh; khi chưa đủ căn cứ, nó nên dẫn đường cho thủ tục kiểm tra tiếp theo, chứ không thay thế thủ tục ấy.
Dữ liệu lớn mở thêm hướng phát hiện gian lận thuế
Kiểm toán thu ngân sách cho thấy rõ vì sao cần mở rộng cách tiếp cận. Ngành thuế đã tiếp nhận hơn 20,3 tỷ hóa đơn điện tử và trên 99% doanh nghiệp kê khai trực tuyến, trong khi hành vi gian lận ngày càng tinh vi. Nếu chỉ dựa vào chọn mẫu và số liệu tổng hợp, phạm vi bao quát sẽ hạn chế, đặc biệt khi dấu hiệu gian lận liên kết giữa nhiều doanh nghiệp hoặc giao dịch.
Ngày 30/10, Hội đồng khoa học Kiểm toán nhà nước nghiệm thu đề tài nghiên cứu ứng dụng phân tích dữ liệu lớn để phát hiện gian lận thuế trong kiểm toán thu ngân sách. Đề tài đề xuất bộ 10 chỉ báo rủi ro đối với thuế giá trị gia tăng và thuế thu nhập doanh nghiệp; một ví dụ sàng lọc tại Chi cục Thuế huyện Nhơn Trạch, Đồng Nai năm 2020 xác định 611 doanh nghiệp, tương đương 25% mẫu, có lãi gộp nhưng lợi nhuận thuần bằng không hoặc âm. Đây là tín hiệu để kiểm tra, không tự thân chứng minh gian lận.
Lộ trình đề xuất bắt đầu bằng thí điểm có kiểm soát với thuế giá trị gia tăng trong giai đoạn 2027-2028; giai đoạn 2029-2030 mở rộng sang thuế thu nhập doanh nghiệp, thuế thu nhập cá nhân, hoàn thuế và các khu vực kiểm toán; sau năm 2030 hướng tới hoàn thiện, tích hợp nâng cao. Cách đi theo từng bước là hợp lý: phát hiện gian lận thuế bằng dữ liệu lớn có thể tăng độ bao quát, nhưng chỉ kiểm soát chất lượng, xác minh và xét đoán chuyên môn mới biến khả năng ấy thành kết luận đáng tin.