
Từ 100.000 lên 1 triệu personas: vì sao bước nhảy dữ liệu này quan trọng?
Nemotron-Personas-Vietnam là bộ dữ liệu AI Việt Nam gồm các chân dung người dùng giả lập, được tạo hoàn toàn bằng AI dựa trên phân bố dân số và lao động thực tế, nhằm phục vụ huấn luyện, kiểm thử và đánh giá các hệ thống AI agentic có khả năng hiểu ngữ cảnh, hành vi và nhu cầu đa dạng của người Việt trong nhiều lĩnh vực khác nhau. Việc FPT và NVIDIA mở rộng bộ dữ liệu này từ 100.000 lên 1 triệu bản ghi không chỉ là câu chuyện tăng số lượng, mà là tuyên bố rõ ràng: nếu muốn có AI agentic phục vụ người Việt một cách có trách nhiệm, chúng ta phải bắt đầu từ hạ tầng dữ liệu mô phỏng dân số đủ sâu và đủ rộng. Ngày 16/10, hai bên công bố phiên bản mở rộng, tăng quy mô gấp 10 lần so với bản đầu tiên ra mắt tháng 6 với 100.000 bản ghi tập trung ở 6 tỉnh, thành phố. Đây là bước đi mang tính chiến lược, đặt nền cho một thế hệ tác tử AI có thể suy luận và hành động trong bối cảnh Việt Nam, thay vì chỉ dịch chuyển mô hình ngoại nhập về mặt ngôn ngữ.
Bộ dữ liệu AI Việt Nam dựa trên nhân khẩu học thật, không đụng dữ liệu cá nhân
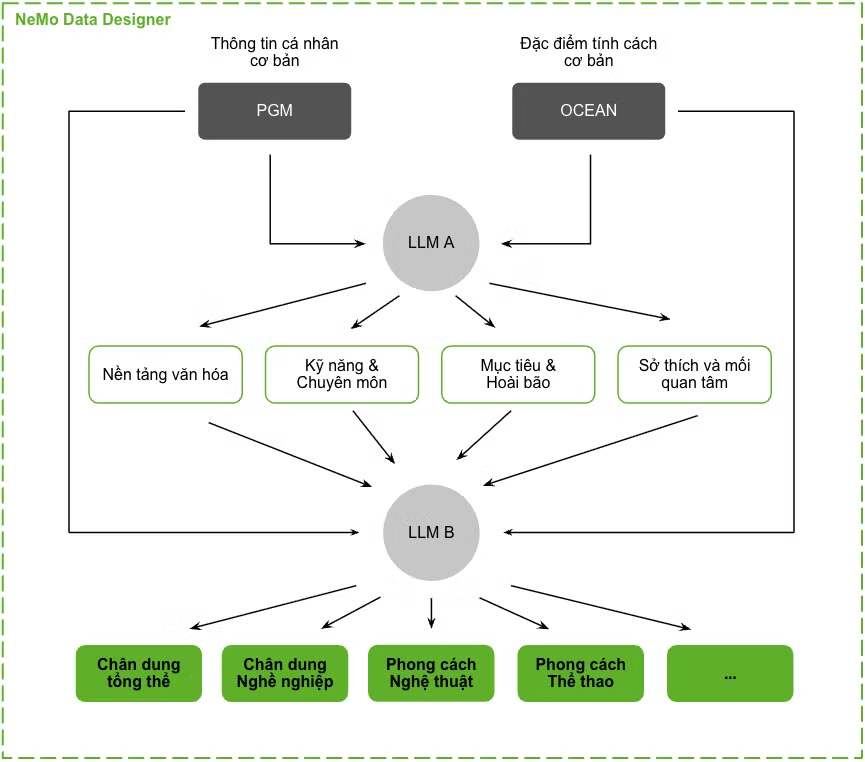
Điểm đáng giá nhất của Nemotron-Personas-Vietnam là cách kết hợp giữa dữ liệu thống kê chính thức và sinh dữ liệu tổng hợp bằng AI. Bộ dữ liệu được xây dựng từ Tổng điều tra dân số và nhà ở năm 2024, Khảo sát mức sống dân cư Việt Nam (VHLSS) 2024, cùng dữ liệu từ FPT Smart Cloud và Viện Quantum AI & Cyber Security, sau đó dùng phương pháp Nemotron-Personas của NVIDIA để tạo chân dung giả lập có độ chân thực cao. Mỗi hồ sơ gồm 21 trường dữ liệu, với 6 trường chân dung và 15 trường bối cảnh, thể hiện tuổi, giới tính, học vấn, nghề nghiệp, nơi sinh sống, kỹ năng, sở thích, kèm các mô tả về công việc, thể thao, du lịch, ẩm thực. Toàn bộ là dữ liệu tổng hợp, không chứa bất kỳ thông tin định danh cá nhân, nhưng vẫn phản ánh cơ cấu tuổi, nghề, học vấn, nơi cư trú theo phân bố dân số thực tế. Nói cách khác, đây là cách "hiểu người Việt ở quy mô lớn" mà không phải đánh đổi quyền riêng tư – một lựa chọn đúng đắn trong bối cảnh nhu cầu dữ liệu cho huấn luyện mô hình AI tăng nhanh.
Hạ tầng dữ liệu cho huấn luyện, kiểm thử và Agentic AI gắn với đời sống
Khi chuyển từ chatbot trả lời câu hỏi sang AI agentic có thể suy luận nhiều bước và tự vận hành nhiệm vụ, bài toán không còn chỉ là chất lượng mô hình mà là chất lượng bối cảnh dữ liệu. Việc nâng Nemotron-Personas-Vietnam lên 1 triệu chân dung mở ra khả năng huấn luyện mô hình AI trên các nhóm người dùng cụ thể: người nghỉ hưu ở TP.HCM, nông hộ nhỏ ở Đồng bằng sông Cửu Long, kỹ sư trẻ tại Đà Nẵng… với số lượng dữ liệu đủ lớn để kiểm thử tin cậy. Quy mô này cho phép huấn luyện mô hình AI, kiểm thử đối kháng (red-teaming) toàn diện hơn, mô phỏng ở cấp độ dân số và đánh giá thiên lệch, tính công bằng trên nhiều nhóm nhân khẩu học. "Quy mô bộ dữ liệu được nâng từ 100.000 lên 1 triệu bản ghi, gấp 10 lần phiên bản ban đầu" – con số này không chỉ đẹp trên giấy, mà trực tiếp quyết định độ phong phú của tình huống mô phỏng trong ngân hàng, y tế, bảo hiểm, dịch vụ công, nơi Agentic AI phải xử lý quy trình phức tạp thay vì trả lời một câu hỏi đơn lẻ.
Tác động thực tế: từ trợ lý ngân hàng đến dịch vụ công hiểu người Việt
Điểm thuyết phục của Nemotron-Personas-Vietnam nằm ở những ví dụ rất đời thường. Khi xây dựng trợ lý AI cho ngân hàng, nhà phát triển có thể tạo hồ sơ giả định một người cao tuổi cần kiểm tra lịch sử giao dịch trên điện thoại, rồi đánh giá xem AI có hướng dẫn rõ ràng, dễ hiểu và phù hợp hay không. Trong dịch vụ khách hàng, doanh nghiệp có thể thử nghiệm với các personas khác nhau về thu nhập, khu vực, mức độ hiểu biết tài chính để điều chỉnh giọng điệu, khuyến nghị sản phẩm và cách xử lý yêu cầu tuân thủ – từ người về hưu ở Hà Nội đến chuyên gia trẻ tại TP.HCM. Với Agentic AI, các tác tử có thể được kết nối công cụ và cấp quyền phù hợp để kiểm tra điều kiện thủ tục, xác định giấy tờ cần chuẩn bị, hỗ trợ điền biểu mẫu cho từng nhóm người dùng cụ thể. Nhờ bộ dữ liệu giả lập, nhiều giai đoạn thử nghiệm có thể giảm phụ thuộc vào hồ sơ khách hàng thật, vừa bảo vệ dữ liệu cá nhân, vừa cho phép kiểm thử trên những tình huống hiếm gặp hoặc khó xử lý mà hệ thống phải sẵn sàng đối mặt.
AI có chủ quyền: Nemotron-Personas-Vietnam như lớp nền dữ liệu dài hạn
Việt Nam đặt mục tiêu kinh tế số đạt khoảng 30% GDP vào năm 2030, kéo theo nhu cầu dữ liệu chân dung thực tế để kiểm thử sản phẩm, cá nhân hóa dịch vụ và đánh giá mô hình AI trong ngân hàng, tài chính, y tế, bảo hiểm, bán lẻ, dịch vụ công. Trong bối cảnh đó, FPT NVIDIA hợp tác mở rộng Nemotron-Personas-Vietnam là một lựa chọn mang tính chủ quyền dữ liệu: thay vì phụ thuộc vào bộ dữ liệu ngoại, chúng ta xây dựng lớp dữ liệu nền tảng đặt trên chính dân số, ngôn ngữ và giá trị trong nước. Việc hai bên tiếp tục đầu tư, duy trì và phát hành mở bộ dữ liệu trên các nền tảng chia sẻ mô hình và dữ liệu AI cho thấy đây không phải dự án thử nghiệm ngắn hạn, mà là nguồn lực dài hạn cho cộng đồng. Nếu Việt Nam muốn có các mô hình và tác tử AI chuyên biệt cho những lĩnh vực yêu cầu cao về quản lý, an toàn, tuân thủ, thì Nemotron-Personas-Vietnam chính là một trong những viên gạch đầu tiên của hạ tầng dữ liệu. Câu hỏi không còn là "có nên làm dữ liệu giả lập hay không", mà là "chúng ta khai thác bộ dữ liệu này nhanh và thông minh đến mức nào" để biến tiềm năng Agentic AI thành dịch vụ hữu ích cho người dùng Việt.